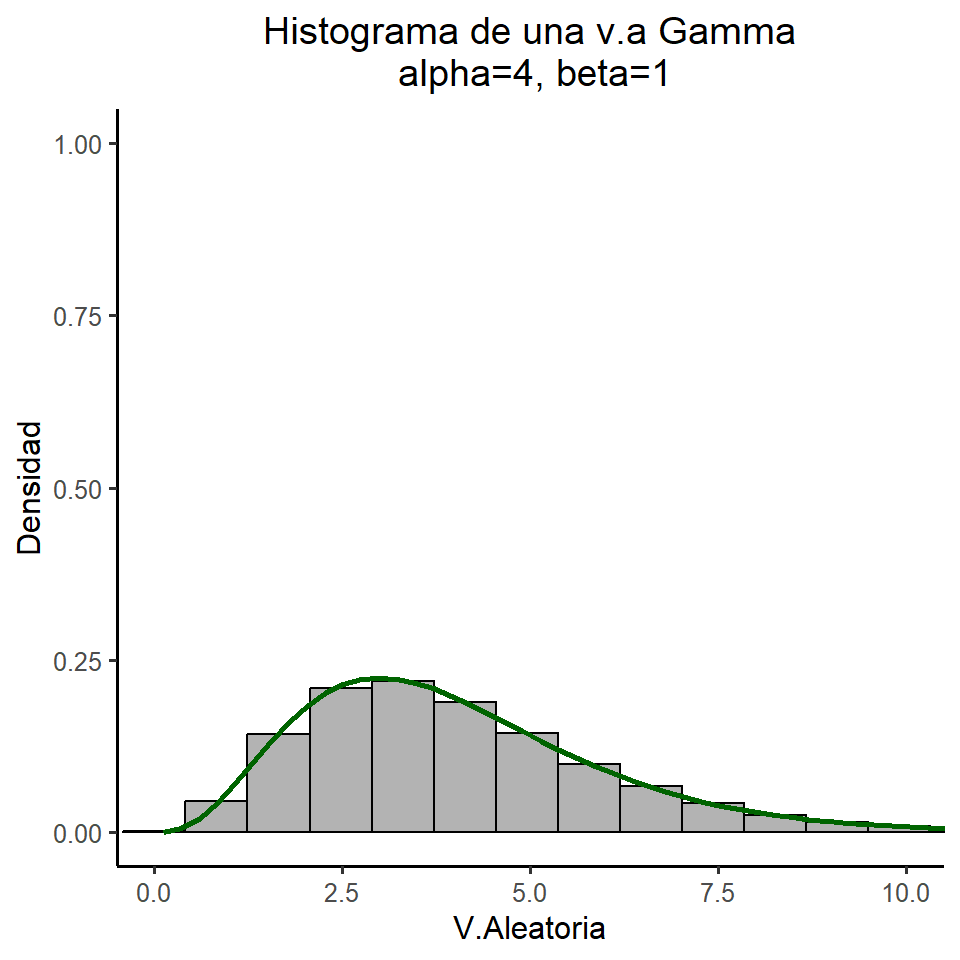
Algunas variables aleatorias son siempre no negativas y presentan distribuciones sesgadas a la derecha (casi toda el área bajo la curva está cerca del origen y decae gradualmente).
Imagine un proceso de Poisson, por ejemplo, el número de carros que entran al parqueo de Ciencias Económicas en una hora (con tasa \(\lambda\)). El tiempo que transcurre entre una llegada y la siguiente se modela con una distribución Exponencial (Caso particular de la gamma).
Si nos interesa el tiempo total que transcurre hasta que lleguen \(n\) carros, sumamos esos tiempos exponenciales independientes. Esa suma sigue una Distribución Gamma, denotada como \(Gamma(\alpha, \beta)\).
Se dice que una variable aleatoria \(X\) tiene distribución de probabilidad Gamma con parámetros \(\alpha > 0\) y \(\beta > 0\) si y solo si su función de densidad es:
\[ f_X(x)= \begin{cases} \dfrac{x^{\alpha-1} e^{-x/\beta}}{\beta^{\alpha}\Gamma(\alpha)}, & 0 \le x < \infty, \\[6pt] 0, & \text{en otro caso.} \end{cases} \]
donde la función Gamma está dada por:
\[ \Gamma(\alpha)=\int_{0}^{\infty} x^{\alpha-1} e^{-x}\,dx. \]
Importante: la Función Gamma NO es lo mismo que la Función de Densidad Gamma.

library(ggplot2)
set.seed(123)
n <- 100000
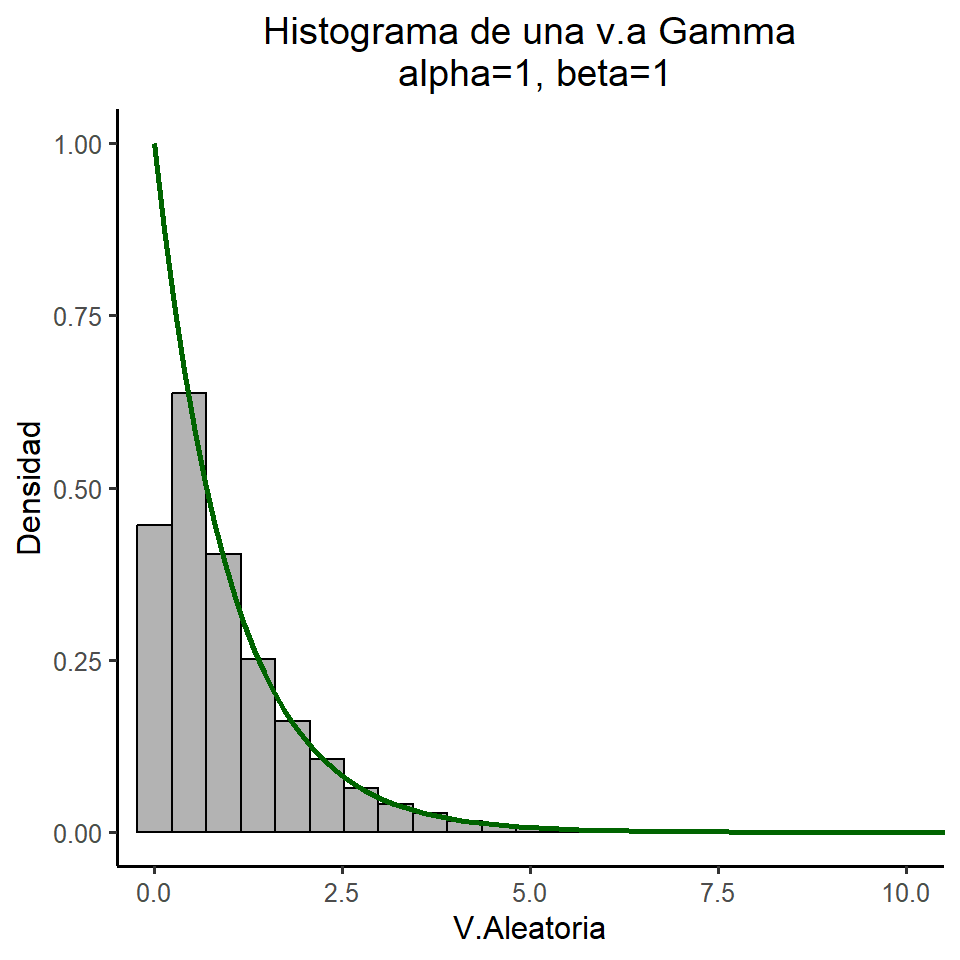
df <- data.frame(vargamma = rgamma(n, shape = 1, scale = 1))
ggplot(df, aes(x = vargamma)) +
geom_histogram(aes(y = after_stat(density)),
bins = 30, fill = "grey70", color = "black") +
stat_function(fun = dgamma, args = list(shape = 1, scale = 1),
linewidth = 0.9, color = "darkgreen") +
coord_cartesian(xlim = c(0, 10), ylim = c(0, 1)) +
labs(
title = "Histograma de una v.a Gamma\ncon alpha=1, beta=1",
x = "V.Aleatoria", y = "Densidad"
) +
theme_classic(base_size = 12) +
theme(plot.title = element_text(hjust = 0.5))
library(ggplot2)
set.seed(123)
n <- 100000
df <- data.frame(vargamma = rgamma(n, shape = 4, scale = 1))
ggplot(df, aes(x = vargamma)) +
geom_histogram(aes(y = after_stat(density)),
bins = 30, fill = "grey70", color = "black") +
stat_function(fun = dgamma, args = list(shape = 4, scale = 1),
linewidth = 0.9, color = "darkgreen") +
coord_cartesian(xlim = c(0, 10), ylim = c(0, 1)) +
labs(
title = "Histograma de una v.a Gamma\ncon alpha=4, beta=1",
x = "V.Aleatoria", y = "Densidad"
) +
theme_classic(base_size = 12) +
theme(plot.title = element_text(hjust = 0.5))
library(ggplot2)
set.seed(123)
n <- 100000
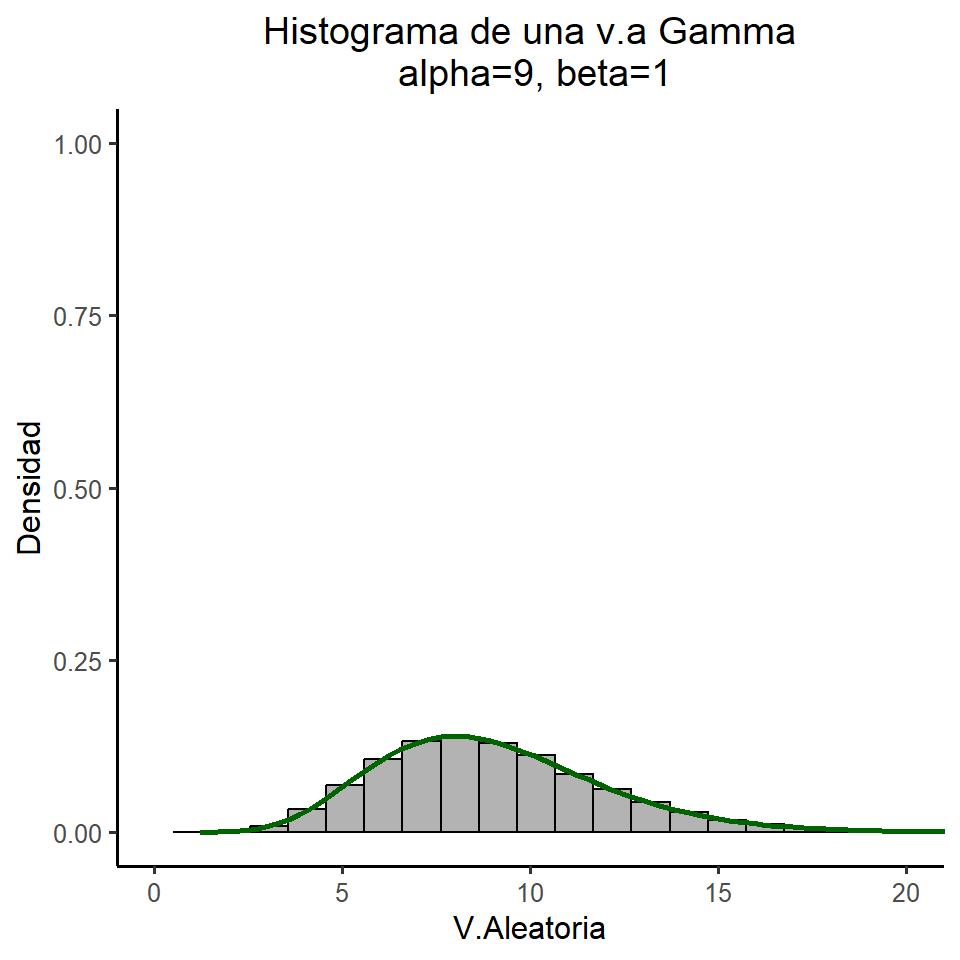
df <- data.frame(vargamma = rgamma(n, shape = 9, scale = 1))
ggplot(df, aes(x = vargamma)) +
geom_histogram(aes(y = after_stat(density)),
bins = 30, fill = "grey70", color = "black") +
stat_function(fun = dgamma, args = list(shape = 9, scale = 1),
linewidth = 0.9, color = "darkgreen") +
coord_cartesian(xlim = c(0, 20), ylim = c(0, 1)) +
labs(
title = "Histograma de una v.a Gamma\ncon alpha=9, beta=1",
x = "V.Aleatoria", y = "Densidad"
) +
theme_classic(base_size = 12) +
theme(plot.title = element_text(hjust = 0.5))
library(ggplot2)
set.seed(123)
n <- 100000
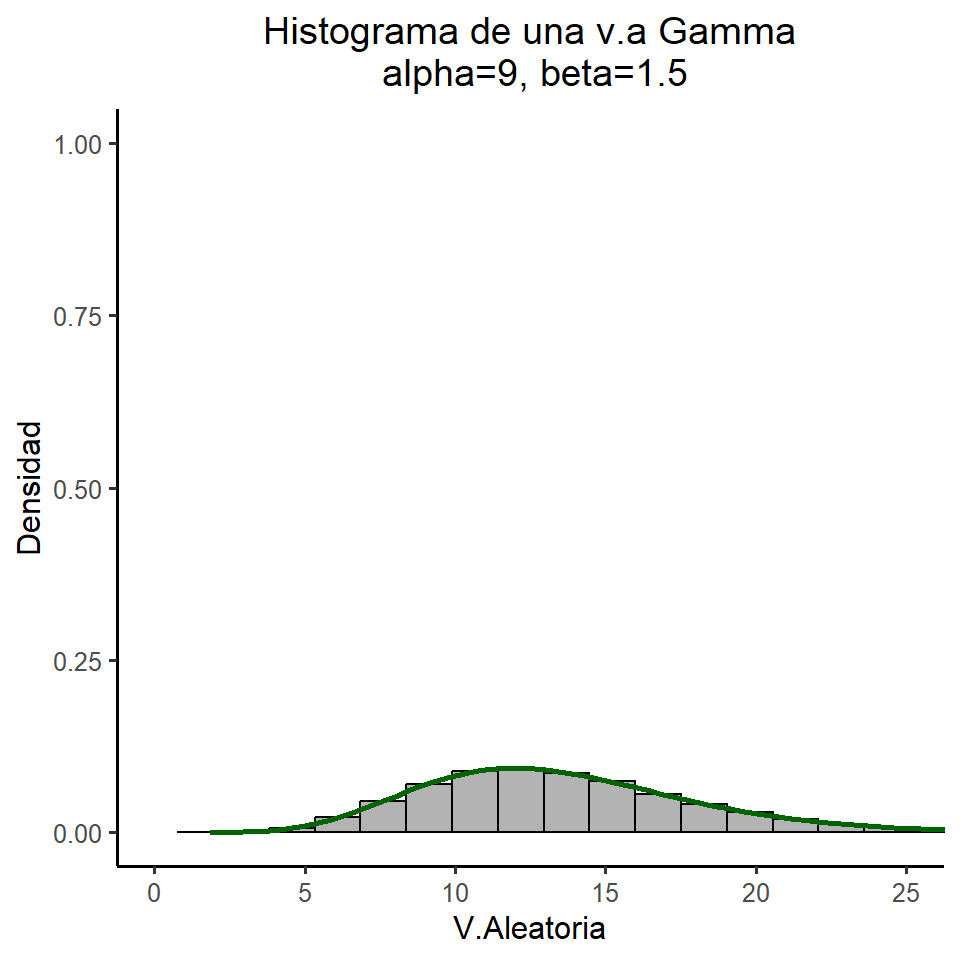
df <- data.frame(vargamma = rgamma(n, shape = 9, scale = 1.5))
ggplot(df, aes(x = vargamma)) +
geom_histogram(aes(y = after_stat(density)),
bins = 30, fill = "grey70", color = "black") +
stat_function(fun = dgamma, args = list(shape = 9, scale = 1.5),
linewidth = 0.9, color = "darkgreen") +
coord_cartesian(xlim = c(0, 25), ylim = c(0, 1)) +
labs(
title = "Histograma de una v.a Gamma\ncon alpha=9, beta=1.5",
x = "V.Aleatoria", y = "Densidad"
) +
theme_classic(base_size = 12) +
theme(plot.title = element_text(hjust = 0.5))Si \(X\) es una variable aleatoria distribuida como Gamma con parámetros \(\alpha\) y \(\beta\), entonces:
\[ E(X) = \alpha \beta, \quad \text{y} \quad Var(X) = \alpha \beta^2. \]
\[ E(X) = \int_{-\infty}^{\infty} x f(x)\,dx = \int_{0}^{\infty} x \, \dfrac{x^{\alpha - 1} e^{-x/\beta}}{\beta^{\alpha} \Gamma(\alpha)} \, dx \]
Sabemos que:
\[ \int_{0}^{\infty} \dfrac{x^{\alpha - 1} e^{-x/\beta}}{\beta^{\alpha} \Gamma(\alpha)} \, dx = 1 \;\; \Rightarrow \;\; \int_{0}^{\infty} x^{\alpha - 1} e^{-x/\beta} \, dx = \beta^{\alpha} \Gamma(\alpha) \]
\[ E(X) = \int_{0}^{\infty} x \, \dfrac{x^{\alpha - 1} e^{-x/\beta}}{\beta^{\alpha}\Gamma(\alpha)} \, dx = \dfrac{1}{\beta^{\alpha}\Gamma(\alpha)} \int_{0}^{\infty} x^{\alpha} e^{-x/\beta} \, dx \]
\[ = \dfrac{\beta^{\alpha + 1} \Gamma(\alpha + 1)}{\beta^{\alpha}\Gamma(\alpha)} = \dfrac{\beta \alpha \Gamma(\alpha)}{\Gamma(\alpha)} = \alpha \beta \]
De la misma manera:
\[ E(X^2) = \int_{-\infty}^{\infty} x^2 f(x)\,dx = \int_{0}^{\infty} x^2 \, \dfrac{x^{\alpha - 1} e^{-x/\beta}}{\beta^{\alpha}\Gamma(\alpha)} \, dx = \dfrac{1}{\beta^{\alpha}\Gamma(\alpha)} \int_{0}^{\infty} x^{\alpha + 1} e^{-x/\beta} \, dx \]
\[ = \dfrac{\beta^{\alpha + 2} \Gamma(\alpha + 2)}{\beta^{\alpha}\Gamma(\alpha)} = \dfrac{\beta^2 (\alpha + 1)\alpha \Gamma(\alpha)}{\Gamma(\alpha)} = \alpha(\alpha + 1)\beta^2 \]
Por lo tanto:
\[ Var(X) = E(X^2) - [E(X)]^2 = \alpha(\alpha + 1)\beta^2 - \alpha^2\beta^2 = \alpha\beta^2 \]
Se dice que una variable aleatoria \(X\) tiene una distribución exponencial con parámetro \(\beta > 0\) si y sólo si la función de densidad de \(X\) es:
\[ f_X(x) = \begin{cases} \dfrac{1}{\beta} e^{-x/\beta}, & 0 \le x < \infty, \\[6pt] 0, & \text{en cualquier otro punto.} \end{cases} \]
La función de densidad exponencial a menudo es de ayuda para modelar la vida útil de componentes electrónicos.
Si \(X\) es una variable aleatoria exponencial con parámetro \(\lambda\) entonces:
\[ \mu = E(X) = \lambda, \quad \sigma^2 = V(X) = \lambda^2 \]
Prueba: Ejercicio.
Suponga que \(X\) tiene una función de densidad de probabilidad exponencial. Demuestre que, si \(a > 0\) y \(b > 0\),
\[\small P(X > a + b \mid X > a) = P(X > b) \]
Solución
\[\small P(X > a + b \mid X > a) = \dfrac{P(X > a + b, X > a)}{P(X > a)} = \dfrac{P(X > a + b)}{P(X > a)} \]
\[\small P(X > a + b) = \int_{a + b}^{\infty} \dfrac{1}{\beta} e^{-x/\beta}\,dx = e^{-(a+b)/\beta} \]
\[\small P(X > a) = \int_{a}^{\infty} \dfrac{1}{\beta} e^{-x/\beta}\,dx = e^{-a/\beta} \]
\[\small P(X > a + b \mid X > a) = \dfrac{e^{-(a+b)/\beta}}{e^{-a/\beta}} = e^{-b/\beta} = P(X > b) \]
\(\tiny \text{Esta propiedad se conoce como la propiedad sin memoria ya que la probabilidad de que el evento ocurra después de un tiempo adicional $b$ no depende del tiempo transcurrido $a$.}\)
Sea \(\nu\) un entero positivo. Se dice que una variable aleatoria \(X\) tiene distribución Ji-cuadrada \(\chi^2\) con \(\nu\) grados de libertad si y solo si
\(X\) es una variable aleatoria con distribución Gamma con parámetros \(\alpha = \nu/2\) y \(\beta = 2\).
Si \(X\) es una variable aleatoria \(\chi^2\) con \(\nu\) grados de libertad, entonces:
\[ \mu = E(X) = \nu, \quad \sigma^2 = V(X) = 2\nu \]
Prueba: Ejercicio.
En casi todos los textos de estadística se pueden ver tablas que dan probabilidades asociadas con distribuciones \(\chi^2\). Además si \(X\) tiene una distribución \(Gamma(a = \frac{n}{2}, \beta)\), para algún entero \(n\) entonces \(Y = \frac{2X}{\beta}\) tiene una distribución \(\chi^2\) con \(n\) grados de libertad.
La magnitud de temblores en cierta región se modela con una distribución exponencial de media \(2.4\) (\(\beta=2.4\)). Calcule:
a) Probabilidad de que un temblor tenga una magnitud mayor a 3.0
\[\small P(X>3)=1-F(3)=1-\!\int_{0}^{3}\frac{1}{\beta}e^{-x/\beta}\,dx =1-(1-e^{-3/\beta})=e^{-3/\beta}. \]
\[\small P(X>3)=e^{-3/2.4}\approx 0.2865048. \]
b) Probabilidad de que un temblor tenga una magnitud entre 2.0 y 3.0
\[\small P(2<X<3)=F(3)-F(2)=(1-e^{-3/\beta})-(1-e^{-2/\beta}) = 0.1480934. \]
Suponga que el tiempo (en minutos) que tarda un estudiante en resolver un problema de un quiz de estadística sigue una distribución Exponencial con media de 5 minutos (\(\beta=5\)). Si un estudiante debe resolver 3 problemas independientes, ¿cuál es la probabilidad de que termine el quiz en menos de 10 minutos?
Solución:
El tiempo total \(X\) es la suma de 3 exponenciales, por lo que \(X \sim Gamma(\alpha=3, \beta=5)\).
Calculamos \(P(X < 10)\):
Cuando \(\alpha\) es un entero y \(\alpha \ne 1\) (una exponencial), podemos expresar la función de distribución de una variable aleatoria con distribución Gamma como una suma de ciertas probabilidades de Poisson.
Si \(\alpha\) no es entero y \(0 < a < b < \infty\), entonces esta integral no tiene una expresión cerrada:
\[ \int_a^b \dfrac{x^{\alpha - 1} e^{-x/\beta}}{\beta^{\alpha} \Gamma(\alpha)}\, dx \]
Por lo tanto, se requiere software estadístico para evaluar \(F_X(x)\).
La distribución Gamma tiene dos parámetros:
Se dice que una variable aleatoria \(X\) tiene una distribución Beta con parámetros \(\alpha>0\) y \(\beta>0\) si y sólo si su función de densidad es:
\[ f_X(x)= \begin{cases} \dfrac{x^{\alpha-1}(1-x)^{\beta-1}}{B(\alpha,\beta)}, & 0 \le x \le 1,\\[6pt] 0, & \text{en cualquier otro punto.} \end{cases} \]
con
\[ B(\alpha,\beta)=\int_{0}^{1} x^{\alpha-1}(1-x)^{\beta-1}\,dx = \dfrac{\Gamma(\alpha)\,\Gamma(\beta)}{\Gamma(\alpha+\beta)}. \]
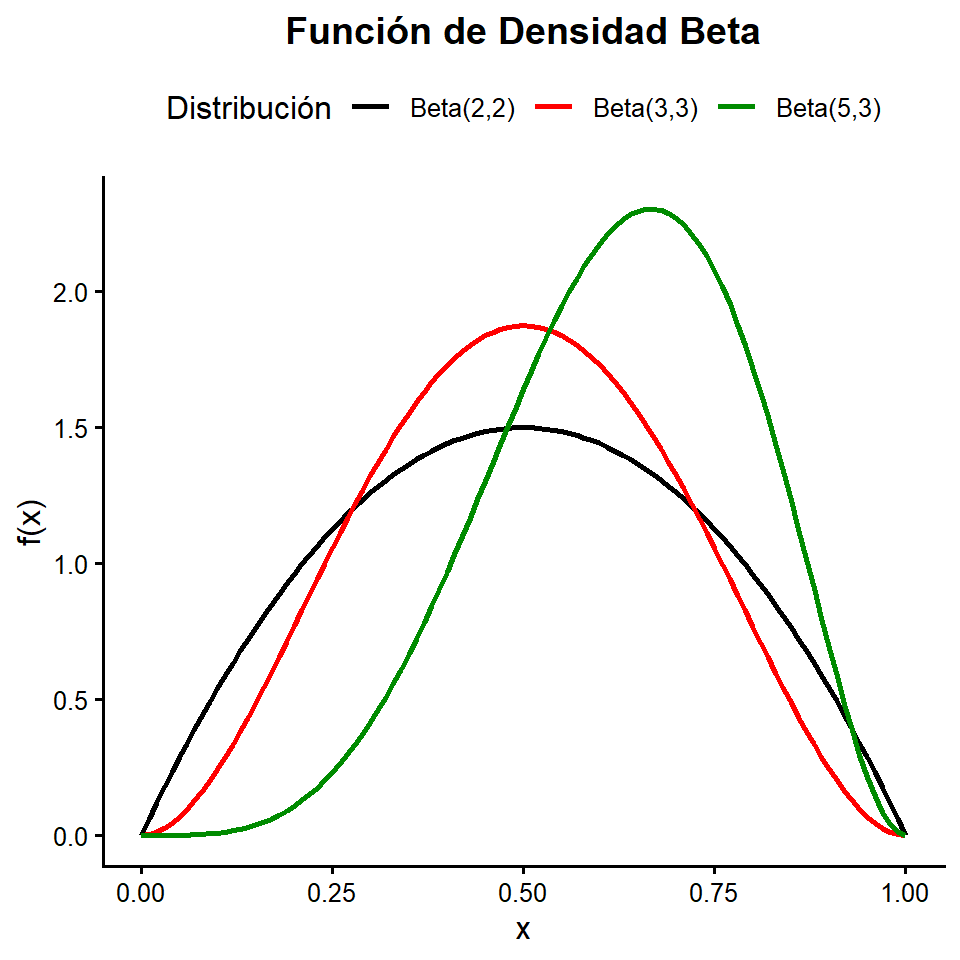
La función de densidad beta es una función de densidad de dos parámetros definida sobre el intervalo cerrado \(0 \le x \le 1\). Frecuentemente se usa como modelo para proporciones, por ejemplo como la proporción de impurezas en un producto químico o la proporción de tiempo que una máquina está en reparación.

De igual forma de la función de densidad va a depender de los valores de \(\alpha\) y \(\beta\).
library(ggplot2)
x <- seq(0, 1, 0.01)
df <- data.frame(
x = rep(x, 3),
densidad = c(dbeta(x, 5, 3), dbeta(x, 3, 3), dbeta(x, 2, 2)),
distribucion = factor(c(
rep("Beta(5,3)", length(x)),
rep("Beta(3,3)", length(x)),
rep("Beta(2,2)", length(x))
))
)
ggplot(df, aes(x = x, y = densidad, color = distribucion)) +
geom_line(linewidth = 1) +
labs(
title = "Función de Densidad Beta",
x = "x",
y = "f(x)",
color = "Distribución"
) +
scale_color_manual(values = c("black", "red", "green4")) +
theme_classic(base_size = 12) +
theme(
plot.title = element_text(hjust = 0.5, face = "bold"),
legend.position = "top"
)Observe que definir \(x\) en el intervalo \(0 \le x \le 1\) no restringe el uso de la distribución Beta.
Si \(c \le x \le d\), entonces se puede definir una nueva variable:
\(x^* = \dfrac{x - c}{d - c}\) de modo que \(0 \le x^* \le 1\).
Cambio de escala: La función de densidad Beta puede aplicarse a una variable aleatoria definida en el intervalo \(c \le x \le d\) mediante traslación y cambio de escala.
La función de distribución acumulativa (FDA) para la variable Beta se denomina función Beta incompleta y se denota por:
\[ F(x) = \int_{0}^{x} \dfrac{t^{\alpha - 1}(1 - t)^{\beta - 1}}{B(\alpha, \beta)}\,dt = I_x(\alpha, \beta) \]
Si \(X\) es una variable aleatoria Beta con parámetros \(\alpha > 0\) y \(\beta > 0\), entonces:
\[\small \mu = E(X) = \dfrac{\alpha}{\alpha + \beta} \quad \text{y} \quad \sigma^2 = V(X) = \dfrac{\alpha \beta}{(\alpha + \beta)^2 (\alpha + \beta + 1)}. \]
Prueba - Utilizamos la definición de \(E(X)\):
\[\small E(X) = \int_{-\infty}^{\infty} x f(x)\,dx = \int_{0}^{1} x \left[ \dfrac{x^{\alpha - 1}(1 - x)^{\beta - 1}}{B(\alpha, \beta)} \right] dx = \dfrac{1}{B(\alpha, \beta)} \int_{0}^{1} x^{\alpha}(1 - x)^{\beta - 1}\,dx \]
Sabemos que:
\[\small \dfrac{B(\alpha + 1, \beta)}{B(\alpha, \beta)} = \dfrac{\Gamma(\alpha + \beta)}{\Gamma(\alpha)\Gamma(\beta)} \cdot \dfrac{\Gamma(\alpha + 1)\Gamma(\beta)}{\Gamma(\alpha + \beta + 1)} = \dfrac{\Gamma(\alpha + \beta)}{\Gamma(\alpha)\Gamma(\beta)} \cdot \dfrac{\alpha \Gamma(\alpha)\Gamma(\beta)}{(\alpha + \beta)\Gamma(\alpha + \beta)} = \dfrac{\alpha}{\alpha + \beta} \]
Por tanto:
\[\small E(X) = \dfrac{\alpha}{\alpha + \beta} \]
La proporción de impurezas en un lote de un producto químico particular es una variable aleatoria \(X\) que se modela mediante una distribución Beta con parámetros \(\alpha = 3\) y \(\beta = 2\).
a) Calcule el valor esperado y la varianza de la proporción de impurezas en un lote.
b) Plantee la integral necesaria para calcular la probabilidad de que un lote tenga más de un 40% de impurezas.
Solución a): Si \(\small X \sim Beta(\alpha, \beta)\): \[\small E(X) = \frac{\alpha}{\alpha + \beta} = \frac{3}{3 + 2} = 0,60\] \[\small Var(X) = \frac{\alpha \beta}{(\alpha + \beta)^2 (\alpha + \beta + 1)} = \frac{3 \cdot 2}{(3 + 2)^2 (3 + 2 + 1)} = 0,04\]
El lote tiene en promedio un 60% de impurezas.
Solución b): Solicitan \(\small P(X > 0,4)\). Se tiene que la función de densidad es \(\small f(x) = \frac{x^{3-1}(1-x)^{2-1}}{B(3,2)}\) para \(\small 0 \le x \le 1\). Por ende:
\[\small P(X > 0,4) = \int_{0,4}^{1} \frac{x^2(1-x)^1}{B(3,2)} \,dx = 0.8208\] Nota: \(\small B(3,2) = \frac{\Gamma(3)\Gamma(2)}{\Gamma(5)} = \frac{2! \cdot 1!}{4!} = \frac{2}{24} = \frac{1}{12}\)
Cuado \(\alpha\) y \(\beta\) son enteros positivos, la función \(I_x(\alpha, \beta)\) está relacionada con la función de probabilidad binomial. Es posible usar integración por partes para demostrar que, si \(0 < x < 1\) y \(\alpha, \beta\) son enteros, entonces:
\[ F(x) = \int_{0}^{x} \dfrac{t^{\alpha - 1}(1 - t)^{\beta - 1}}{B(\alpha, \beta)}\,dt = \sum_{i = \alpha}^{n} \binom{n}{i} x^{i}(1 - x)^{n - i}, \]
donde: \(n = \alpha + \beta - 1\)
La suma del lado derecho representa la suma de probabilidades asociadas a una variable aleatoria binomial con:
\[ n = \alpha + \beta - 1, \quad p = x. \]
Suponga que la proporción del tiempo que una máquina empaquetadora industrial está en reparación durante una semana de trabajo es una variable aleatoria \(\small X \sim Beta(4, 2)\).
Utilizando la relación con la distribución Binomial, calcule la probabilidad de que la máquina esté en reparación menos del 30% del tiempo, es decir, \(P(X \le 0,3)\). (Nota: Realice el cálculo analítico sin integrar y luego valide integrando o usando la función pbeta).
Se tiene que: \(\small X \sim Beta(\alpha = 4, \beta = 2)\)
\(\small n = \alpha + \beta - 1 = 5\)
\(\small p = x = 0,3\).
\(\small Y \sim Binomial(n=5, p=0,3)\).
Entonces La integral acumulada de la Beta es igual a la suma de probabilidades binomiales desde \(\small \alpha\) hasta \(\small n\).
\[\small P(X \le 0,3) = \sum_{i = \alpha }^{n} \binom{n}{i} x^{i}(1 - x)^{n - i} = \sum_{i = 4}^{5} \binom{5}{i} 0.3^{i}(1 - 0.3)^{5 - i} = P(Y \ge 4)\]
\[\small P(Y \ge 4) = P(Y = 4) + P(Y = 5)\] \[\small P(Y \ge 4) = \binom{5}{4}(0,3)^4(1 - 0,3)^{5 - 4} + \binom{5}{5}(0,3)^5(1 - 0,3)^{5 - 5}\] \[\small P(Y \ge 4) = 5(0,0081)(0,7) + 1(0,00243)(1) = 0,03078\]
Por lo tanto, la probabilidad de que la máquina esté en reparación menos del 30% del tiempo es 0,03078. (Tarea validar usando integración).
El Teorema de De Moivre-Laplace establece que, bajo ciertas condiciones, la distribución de una variable aleatoria binomial puede aproximarse a una distribución normal.
Sea \(X \sim Bin(n,p)\), cuya función de probabilidad exacta es: \[f(x) = \binom{n}{x} p^{x} (1-p)^{n-x}\]
Cuando el tamaño de la muestra (\(n\)) es suficientemente grande, la función de probabilidad converge a la campana de Gauss: \[\lim_{n \to \infty} f(x) = \frac{1}{\sqrt{npq}\sqrt{2\pi}} e^{-\frac{1}{2}\left(\frac{x-np}{\sqrt{npq}}\right)^2}\]
Esto nos permite aproximar las probabilidades estandarizando la variable. La probabilidad original se transforma en una probabilidad sobre la distribución normal estándar (\(Z\)): \[P(np + a\sqrt{npq} \le X \le np + b\sqrt{npq}) = P\left(a \le \frac{X-np}{\sqrt{npq}} \le b\right)\] \[P(a \le Z \le b) \approx \int_{a}^{b} \frac{1}{\sqrt{2\pi}} e^{-\frac{1}{2}z^2} dz\]
Dado que la distribución binomial es discreta (toma valores enteros) y la normal es continua, la aproximación mejora de forma sustancial si aplicamos una corrección por continuidad sumando o restando \(0,5\) a los límites del intervalo.
Condiciones para una buena aproximación: Para utilizar este método, generalmente se requiere que tanto el número de éxitos como el de fracasos esperados sean mayores o iguales a 5: * \(np \ge 5\) * \(nq \ge 5\)
Si \(c\) y \(d\) son números enteros, la fórmula aproximada con la corrección aplicada es: \[P(c \le X \le d) \approx \Phi\left(\frac{d + 0,5 - np}{\sqrt{npq}}\right) - \Phi\left(\frac{c - 0,5 - np}{\sqrt{npq}}\right)\] (Donde \(\Phi\) representa la función de distribución acumulada de la Normal Estándar).
Enunciado: Un dado se tira 3000 veces. Calcular la probabilidad de que el número de unos \(X\) sea mayor o igual a 480 y menor o igual a 530.
Tenemos:
\(np = 3000 \cdot (1/6) = 500\) (Se cumple \(np \ge 5\))
\(nq = 3000 \cdot (5/6) = 2500\) (Se cumple \(nq \ge 5\))
Media (\(\mu\)): \(\mu = np = 500\)
Desviación estándar (\(\sigma\)): \(\sigma = \sqrt{npq} = \sqrt{3000 \cdot \frac{1}{6} \cdot \frac{5}{6}} \approx 20,41\)
Entonces:
\[\small P(480 \le X \le 530) \approx \Phi\left(\frac{530 + 0,5 - 500}{20,41}\right) - \Phi\left(\frac{480 - 0,5 - 500}{20,41}\right)\] \[\small P(480 \le X \le 530) \approx \Phi(1,49) - \Phi(-1,004)\] \[\small P(480 \le X \le 530) \approx 0,93189 - 0,15866 = 0,77323\]
Enunciado: La confiabilidad de un fusible eléctrico es la probabilidad de que funcione adecuadamente al ser elegido al azar. Se probó una muestra de 1400 fusibles. Calcule la probabilidad aproximada de observar 27 o más fusibles defectuosos, suponiendo una confiabilidad de fábrica del 0,98.
Tenemos:
\(np = 1400 \cdot 0,02 = 28\) (Se cumple \(np \ge 5\))
\(nq = 1400 \cdot 0,98 = 1372\) (Se cumple \(nq \ge 5\))
Media (\(\mu\)): \(\mu = np = 28\)
Desviación estándar (\(\sigma\)): \(\sigma = \sqrt{npq} = \sqrt{1400 \cdot 0,02 \cdot 0,98} \approx 5,238\)
Entonces: \[\small P(X \ge 27) = 1 - P(X < 27) \approx 1 - \Phi\left(\frac{27 - 0,5 - 28}{5,238}\right)\] \[\small P(X \ge 27) \approx 1 - \Phi(-0,286)\] \[\small P(X \ge 27) \approx 1 - 0,387 = 0,613\]
Uniforme: 4.39 - 4.57
Normal: 4.58 - 4.80
Gamma: 4.81 - 4.112
Beta: 4.136 - 4.145