Contraste más Potente y Lema de Neyman Pearson
XS-0122 Fundamentos de Teoría Estadística - I Semestre 2026
Basada en las presentaciones de Shu Wei Cho
¿Qué vamos a discutir hoy?
- Hemos visto hasta ahora sobre
- Todo sobre estimadores puntuales + pivotes e intervalos de confianza.
- Contrastes de hipótesis (función de potencia, tamaño del contraste, el valor p).
- Ahora:
- Contrastes de hipótesis: constrastes más potentes y uniformemente más potentes. Cocientes de verosimilitud.
Contrastes más potentes
Es deseable encontrar un contraste donde las probabilidades \(\alpha(\delta)\) y \(\beta(\delta)\) sean lo más pequeñas posibles.
Es posible que uno de los dos errores tenga probabilidad cero, por ejemplo tener un contraste donde \(H_0\) se rechace siempre haciendo que la probabilidad de Error Tipo I siempre sea cero. No obstante, este contraste hace que la probabilidad de cometer un Error Tipo II sea siempre 1, lo que es indeseable.
Es imposible encontrar un contraste que minimice ambas probabilidades de error por lo que nos enfocamos en minimizar una combinación lineal de estas.
Una manera de hacer esto es fijar el tamaño del contraste y encontrar el contraste que tenga la mayor potencia.
Para demostrar el procedimiento, vamos a enfocarnos en un tipo de contraste de hipótesis que contrasta una hipótesis simple contra otra hipótesis simple. Una hipótesis simple y una hipótesis compuesta se definen de la siguiente manera:
Definición 4.6: Hipótesis simple e hipótesis compuesta. Sea \(X_{1}, X_{2}, ... , X_{n}\) una muestra aleatoria de una distribución con parámetro \(\theta\). Se dice que una hipótesis es simple si especifica de manera única la distribución de la población. Cualquier hipótesis que no sea simple se denomina hipótesis compuesta.
Supongamos que tenemos una muestra aleatoria donde \(X_j \sim N(\mu,1)\) y tenemos las hipótesis \(H_{0}: \mu = 0\) y \(H_{1}: \mu \neq 0\). En este caso la hipótesis nula nos dice que los datos pertenecen a una población \(N(0,1)\) mientras que la hipótesis alterna no especifica la distribución de manera única, por lo que \(H_0\) es una hipótesis simple mientras que \(H_1\) es una hipótesis compuesta.
Supongamos ahora que \(X_j \sim N(\mu,\sigma^2)\) donde \(\sigma^{2} > 0\) y es desconocido. En este caso la hipótesis nula \(H_{0}: \mu = 0\) es una hipótesis compuesta ya que no está especificando la distribución de la población de una única manera (depende de \(\sigma^{2}\), el cual puede ser cualquier valor positivo).
Volviendo al objetivo de encontrar un buen contraste supongamos que queremos contrastar dos hipótesis simples y que fijamos el tamaño del contraste en un valor \(\alpha_0\) dado. De todos los posibles contrastes que existan con el mismo tamaño \(\alpha_0\), el contraste más potente va a ser aquel que tenga la mayor potencia en \(\Omega_{1}\). Este valor \(\alpha_0\) fijo usualmente se conoce como el nivel de significancia.
Definición 4.7: Contraste más potente. Suponga que se desean contrastar las hipótesis simples \(H_{0}: \theta = \theta_0\) contra \(H_{1}: \theta = \theta_1\) basados en una muestra aleatoria de una población con distribución que depende de \(\theta\). Para un valor \(\alpha_0 \in ( 0,1 )\), sea \[\mathbb{T}_{\alpha_0} = \left\lbrace \delta | \alpha(\delta) = \alpha_0 \right\rbrace\] el conjunto de todos los contrastes \(\delta\) que tienen tamaño \(\alpha_0\). Entonces el contraste de tamaño \(\alpha_0\) más potente, denotado \(\delta^{\ast}\), satisface:
- \(\delta^\ast \in \mathbb{T}_{\alpha_0}\), y
- \(\beta(\delta^\ast) \leq \beta(\delta)\), \(\forall \delta \in \mathbb{T}_{\alpha_0}\).
El punto de este tema es que al enfocarse en solo dos valores para \(\theta\) y fijar el tamaño del contraste en \(\alpha_0\) entonces solo tenemos que concentrarnos en la potencia en \(\theta_1\). En general y en la práctica es raro fijar una hipótesis alterna que sea simple por lo que tendríamos que comparar toda la función potencia en \(\Omega_{1}\) entre distintos contrastes, lo que es considerablemente más complicado de hacer que solo comparar dos valores. No obstante, más adelante en el tema veremos una forma de lograr esto para ciertos contrastes.
Lema de Neyman-Pearson
Una manera de encontrar la región crítica para un contraste más potente \(\delta^*\) se da por medio del Lema de Neyman-Pearson. Este dice lo siguiente:
Teorema 4.1: Lema de Neyman-Pearson. Supongamos que se desea contrastar las hipótesis simples \(H_{0}: \theta = \theta_0\) contra \(H_{1}: \theta = \theta_1\) basados en una muestra aleatoria de una población con distribución que depende de \(\theta\). Además, sea \(\mathcal{L}(\theta)\) la función de verosimilitud de la muestra para un valor de \(\theta\). Para un tamaño dado \(\alpha_0\), el contraste que minimiza \(\beta(\delta)\) tiene una región crítica determinada por:
\[RC_{\delta^\ast} = \left\lbrace \mathbf{X} \left| \frac{\mathcal{L}(\theta_0)}{\mathcal{L}(\theta_1)} < k \right. \right\rbrace,\] para algún \(k>0\).
Contrastes más potentes
Note que:
- Se rechaza \(H_0\) si \(\mathcal{L}(\theta_0) < k\mathcal{L}(\theta_1)\) y se acepta \(H_0\) si \(\mathcal{L}(\theta_0) > k\mathcal{L}(\theta_1)\).
- En el caso en que \(\mathcal{L}(\theta_0) = k\mathcal{L}(\theta_1)\) se puede favorecer cualquiera de las dos hipótesis.
- El valor de \(k\) se selecciona de manera que el contraste tenga tamaño \(\alpha_0\). Este contraste se denomina como contraste más potente para un tamaño \(\alpha_0\), pues es la prueba con un valor máximo de \(\operatorname{Potencia}(\theta_1)\).
Podemos observar que un contraste con esta región crítica tiene sentido con la interpretación de la función de verosimilitud. Recordemos que entre más verosímil es un valor de \(\theta\) para la muestra dada, mayor es su función de verosimilitud. Por lo tanto, si \(\theta = \theta_0\) entonces se espera que \(\mathcal{L}(\theta_0) > \mathcal{L}(\theta_1)\), favoreciendo a \(H_0\) sobre \(H_1\) y viceversa. De esta manera el contraste más potente consiste en escoger la hipótesis más verosímil para la muestra obtenida, fijando de antemano una máxima probabilidad de cometer Error Tipo I.
Ejemplo: Suponga que \(Y\) representa una sola observación con función de densidad dada por:
\(f_{Y}(y) = \begin{cases}\theta y^{\theta-1} \quad si \quad 0 \leq y \leq 1 \\0 \quad en \quad otros \quad casos \end{cases}\)
Determine el contraste más potente con un tamaño \(\alpha_0 = 0.05\), para contrastar \(H_{0}: \theta = 2\) contra \(H_{1}: \theta = 1\).
Solución: Por el Lema de Neyman-Pearson sabemos que se rechaza \(H_0\) si \(\frac{\mathcal{L}(2)}{\mathcal{L}(1)} < k\). Debemos encontrar esta expresión para el ejemplo que tenemos. En este caso la verosimilitud viene dada por: \(\mathcal{L}(\theta) = \theta y^{\theta-1}\)
Por lo tanto, al evaluar en \(\Omega_{0}\) y \(\Omega_{1}\) tenemos:
\(\mathcal{L}(2) = 2y, \qquad \qquad \mathcal{L}(1) = 1, \qquad \qquad \Rightarrow \frac{\mathcal{L}(2)}{\mathcal{L}(1)} = 2y\)
Por lo tanto, rechazamos \(H_0\) si \(2Y < k\), lo que equivale a decir que rechazamos si \(Y < k^{\prime}\), donde \(k^{\prime} = k/2\). Ahora debemos encontrar el valor de \(k^{\prime}\) para que el contraste tenga un tamaño de 0.05.
\(P(Y < k^{\prime} | \theta = 2) = F_{Y}(k^{\prime}| \theta = 2) = {k^{\prime}}^{2} = 0.05, \quad \Rightarrow k^{\prime} = \sqrt{0.05}\)
Podemos concluir que el contraste más potente consiste en rechazar \(H_0\) si \(Y < \sqrt{0.05}\), con un nivel de significancia de 0.05. Observen que no es necesario encontrar el valor de \(k\) exacto, ya que el tamaño del contraste va a seguir siendo igual. Solo queremos encontrar una regla de decisión para el contraste.
Ejemplo: Sea \(X_{1}, X_{2}, ... , X_{n}\) una muestra aleatoria tal que \(X_j \sim N(\mu,1)\). Se desea contrastar las hipótesis \(H_{0}: \mu = \mu_0\) contra \(H_{1}: \mu = \mu_1\), donde \(\mu_0 < \mu_1\). Obtenga el contraste más potente para un tamaño dado \(\alpha_0\).
Solución: Recordemos que para esta muestra normal la verosimilitud viene dada por la siguiente expresión:
\(\mathcal{L}(\mu) = (2\pi)^{-\frac{n}{2}} e^{-\frac{\sum(x_{j}-\mu)^{2}}{2}} = (2\pi)^{-\frac{n}{2}} e^{-\frac{\sum{x_{j}^{2}} -2n\mu \bar{x} + n\mu^2 }{2}}\)
Por lo tanto cuando obtenemos el cociente de las verosimilitudes para encontrar la región crítica según el Lema de Neyman-Pearson obtenemos:
\(\frac{\mathcal{L}(\mu_0)}{\mathcal{L}(\mu_1)} = \frac{e^{n\mu_{0} \bar{x} -\frac{n\mu_{0}^{2}}{2}}}{e^{n\mu_{1} \bar{x} -\frac{n\mu_{1}^{2}}{2}}} = e^{n\left( \bar{x}(\mu_0 - \mu_1 ) -\frac{1}{2}( \mu_{0}^2 - \mu_{1}^2 ) \right) } = e^{ n\bar{x}(\mu_0 - \mu_1 ) } \cdot e^{ -\frac{n}{2}( \mu_{0}^2 - \mu_{1}^2 ) } < k\)
A partir de esta expresión debemos encontrar el valor crítico de la prueba, ya sabemos que rechazamos \(H_{0}\) si:
\(e^{ n\bar{x}(\mu_0 - \mu_1 ) } \cdot e^{ -\frac{n}{2}( \mu_{0}^2 - \mu_{1}^2 ) } < k\) \(\Rightarrow e^{ n\bar{x}(\mu_0 - \mu_1 ) } < k e^{\frac{n}{2}( \mu_{0}^2 - \mu_{1}^2 ) }\) \(\Rightarrow n\bar{x}(\mu_0 - \mu_1 ) < \ln{ \left( k e^{\frac{n}{2}( \mu_{0}^2 - \mu_{1}^2 ) } \right) }\) \(\Rightarrow \bar{x} > \frac{ \ln{ \left( k e^{\frac{n}{2}( \mu_{0}^2 - \mu_{1}^2 ) } \right) } }{n(\mu_0 - \mu_1 )} = k^{\prime}\)
Por lo tanto, nuestro contraste consiste en rechazar \(H_0\) si \(\bar{X} > k^{\prime}\). Ahora debemos encontrar el valor de \(k^{\prime}\) para un tamaño dado \(\alpha_0\):
\(\alpha_0 = P\left( \bar{X} > k^{\prime} | \mu = \mu_{0} \right) = P\left( Z > \sqrt{n}(k^{\prime} - \mu_{0}) \right)\)
Usando el software adecuado podemos encontrar que \(z_{1-\alpha_0} = \sqrt{n}(k^{\prime} - \mu_{0})\). Por lo tanto podemos despejar el valor de \(k^{\prime}\) y encontrar que queda: \(k^{\prime} = \mu_{0} + \frac{z_{1-\alpha_0}}{\sqrt{n}}\), y por lo tanto, nuestro contraste más potente consiste en rechazar \(H_0\) si \(\bar{X} > \mu_{0} + \frac{z_{1-\alpha_0}}{\sqrt{n}}\) para un nivel de significancia \(\alpha_0\).
Contrastes uniformemente más potentes
Una observación interesante que podemos realizar del ejemplo anterior es que este no depende realmente del valor de la hipótesis alterna, solo depende del valor de la hipótesis nula y de la relación entre ambos valores; esto es un patrón común con los contrastes obtenidos mediante el Lema de Neyman-Pearson. Por lo tanto, en ciertos casos, nos es posible generalizar el resultado de este tipo de contrastes para más de un valor en \(H_1\).
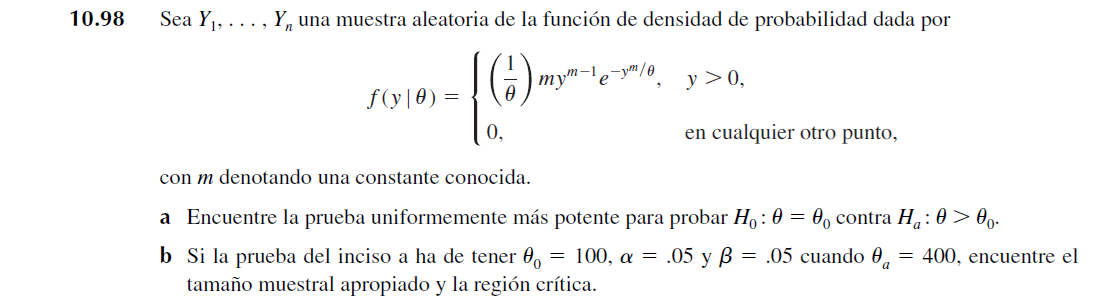
Supongamos que se desea probar las hipótesis \(H_{0}: \theta = \theta_0\) contra \(H_{1}: \theta > \theta_0\). En este caso parece que no podemos aplicar el Lema de Neyman-Pearson pues la hipótesis alterna es compuesta. Sin embargo, podemos redefinir la hipótesis alterna como \(H_{1}: \theta = \theta_1\), donde \(\theta_1 > \theta_0\). De esta manera tenemos un contraste de hipótesis simples al que le podemos aplicar el Lema de Neyman-Pearson y que donde ya vimos que el valor de \(\theta_1\) no se utiliza en la definición de la región crítica. Podemos definir esto de la siguiente manera:
Definición 4.8: Contraste uniformemente más potente. Un contraste de tamaño \(\alpha_0\) es uniformemente más potente (UMP) para contrastar \(H_{0}:\theta = \theta_0\) contra \(H_{1}: \theta \in \Omega_{1}\) si es más potente para \(H_{0}:\theta = \theta_0\) contra \(H_{1}: \theta = \theta_1\), para todo \(\theta_1 \in \Omega_{1}\).
Bajo esta definición vamos a poder encontrar fácilmente contrastes UMP para las hipótesis alternas \(H_{1}: \theta > \theta_0\) o \(H_{1}: \theta < \theta_0\), siempre y cuando la distribución poblacional lo permite. Sin embargo, no es posible encontrar un contraste UMP para la hipótesis alterna \(H_{1}: \theta \neq \theta_0\) ya que será imposible encontrar el mismo contraste más potente para todo valor de \(\theta_1\) diferente de \(\theta_0\).
Ejercicio:
Un banco asegura que el tiempo de espera del cliente en las cajas sigue una distribución exponencial con media \(\beta_0\). El gerente recibió quejas de los clientes de que el tiempo promedio de espera debe ser más. Decidió recolectar una muestra aleatoria de \(n\) clientes para ver contrastar dos hipótesis: \(H_0: \beta=\beta_0\) contra \(H_1: \beta>\beta_0\).
- Encuentre el contraste uniformemente más potente de tamaño \(\alpha_0\) para contrastar estas hipótesis.
- Suponga que \(\beta_0=5\), \(n=10\) y \(\alpha_0=0.05\). Grafique la función potencia del contraste encontrado en 1.
- Suponga que el tiempo promedio verdadero es \(\beta=15\). Simule una muestra aleatoria de tamaño \(n=10\). Concluya el problema.
- Repita el ejercicio 3 pero suponiendo que el tiempo promedio verdadero es \(\beta=11\). Simule una muestra aleatoria de tamaño \(n=10\). Concluya el problema.
Ejercicio:
¿Qué discutimos hoy?
Contrastes de hipótesis - contrastes más potentes, uniformemente más potentes, cociente de verosimilitudes.