Contraste de Hipótesis Parte 1
[XS-1130 Principios de Inferencia]
¿Qué es una hipótesis estadística?
Definición
Una hipótesis estadística es una afirmación sobre el valor de un parámetro de la población, o sobre la distribución que sigue la población.
Es una afirmación sobre la población, nunca sobre la muestra. Decir que \(\bar x = 218.5\) no es una hipótesis: es un hecho observado. Decir que \(\mu = 220\) sí lo es, porque \(\mu\) no se conoce.
Ejemplos:
- El consumo eléctrico promedio de los hogares del condominio es de 220 kWh.
- La proporción de piezas defectuosas del proceso es 0.05.
- La duración de las baterías se distribuye normalmente.
- El tipo de vivienda y la región de residencia son independientes.
Importante
Estos ejemplos son afirmaciones sobre parámetros poblacionales desconocidos, lo que los convierte en hipótesis.
Dos caminos para la misma pregunta
Hasta el momento se utilizó un estimador para acotar un parámetro mediante un intervalo de confianza y se reportó un rango de valores creíbles. Ahora vamos hacer algo distinto: partimos de un valor propuesto para el parámetro y se decide si los datos lo contradicen.
Estimación y contraste
| Estimación | Contraste | |
|---|---|---|
| Pregunta | ¿Cuáles valores puede tomar el parámetro? | ¿Es creíble este valor? |
| Punto de partida | Nada, solo la muestra | Un valor propuesto para el parámetro \(\theta_0\) |
| Resultado | Un intervalo | Una decisión |
| Riesgo que se controla | Nivel de confianza | Nivel de significancia |
Las dos son inferencia: ambas usan la distribución muestral del estimador para pasar de la muestra a la población.
La verificación como problema de decisión
Al final del procedimiento hay que escoger entre dos acciones, con información incompleta:
- Rechazar la afirmación propuesta.
- No rechazarla.
La verdad es desconocida y seguirá siéndolo. Lo único que se puede hacer es escoger una regla que mantenga controlada la frecuencia con la que esa regla se equivoca.
Importante
Un contraste de hipótesis no descubre la verdad: administra el riesgo de equivocarse. Por eso toda conclusión viene acompañada de un nivel de significancia, que es la tasa de error que se aceptó de antemano.
La lógica de la verificación
El razonamiento es el de una demostración por contradicción, pero en versión probabilística.
- Se supone, de forma provisional, que la afirmación \(H_0\) es verdadera.
- Bajo ese supuesto se conoce la distribución del estimador, y por lo tanto se sabe qué resultados muestrales son comunes y cuáles son raros.
- Se observa la muestra.
- Si el resultado observado es muy raro bajo ese supuesto, se concluye que el supuesto es insostenible y se rechaza.
- Si el resultado es compatible con el supuesto, no hay motivo para rechazarlo.
La asimetría del procedimiento
Encontrar un resultado compatible con \(H_0\) no prueba que \(H_0\) sea cierta: muchos otros valores del parámetro también serían compatibles con esa misma muestra. Por eso se dice no se rechaza y nunca se acepta.
Hipótesis nula y alternativa
Hipótesis nula
\(H_0\) es la afirmación de que el parámetro es igual a un valor concreto. Siempre lleva el signo de igualdad, porque es el valor que permite calcular la distribución del estadístico de prueba.
\[H_0: \mu = \mu_0 \qquad H_0: P = P_0\]
Hipótesis alternativa
\(H_1\) es la afirmación que se sostendría si los datos contradicen a \(H_0\). Nunca lleva el signo de igualdad y usa \(<\), \(>\) o \(\neq\).
\[H_1: \mu < \mu_0 \qquad H_1: \mu > \mu_0 \qquad H_1: \mu \neq \mu_0\]
El valor \(\mu_0\) es el mismo en las dos: lo que cambia es la dirección.
Cómo traducir un enunciado a hipótesis
Tres preguntas, en este orden:
¿Cuál es el parámetro? Si el enunciado habla de promedios es \(\mu\); si habla de porcentajes, proporciones o conteos sobre un total, es \(P\); si habla de asociación entre dos variables categóricas, es independencia.
¿Cuál es el valor de referencia? Es el número que aparece en la afirmación previa, en la norma o en el estudio anterior.
¿Qué quiere demostrar quien investiga? Esa afirmación va en \(H_1\). Las expresiones a lo sumo, al menos, no supera y como mínimo marcan la dirección.
Importante
El valor de referencia nunca sale de la muestra. Plantear \(H_0: \mu = 218.5\) porque la muestra dio 218.5 vacía el procedimiento: el estadístico de prueba valdría cero por construcción.
Ejemplo 1: planteamiento de hipótesis
Escriba \(H_0\) y \(H_1\) en cada caso.
- Un fabricante afirma que sus bombillos duran en promedio 1200 horas. Una asociación de consumidores sospecha que duran menos.
- La proporción de empleados que consigue trabajo por una red de contactos es mayor que 0.5.
- El peso medio de los pasajeros con equipaje de mano es a lo sumo 195 libras.
- Una empresa cambió su proceso y quiere saber si el contenido promedio por envase se modificó.
- La región de residencia y el tipo de vivienda están asociados.
Ejemplo 1: solución
\(H_0: \mu = 1200\) contra \(H_1: \mu < 1200\). Lo que la asociación quiere demostrar es que duran menos, y eso va en \(H_1\).
\(H_0: P = 0.5\) contra \(H_1: P > 0.5\).
\(H_0: \mu = 195\) contra \(H_1: \mu > 195\). A lo sumo 195 es la afirmación que se defiende, así que la contraria, que es lo que se busca refutar con evidencia, va en \(H_1\).
\(H_0: \mu = \mu_0\) contra \(H_1: \mu \neq \mu_0\). Se modificó no indica dirección, así que el contraste es bilateral.
\(H_0\): la región y el tipo de vivienda son independientes, contra \(H_1\): no lo son. Aquí la nula es siempre la independencia.
Verificaciones bilaterales y unilaterales
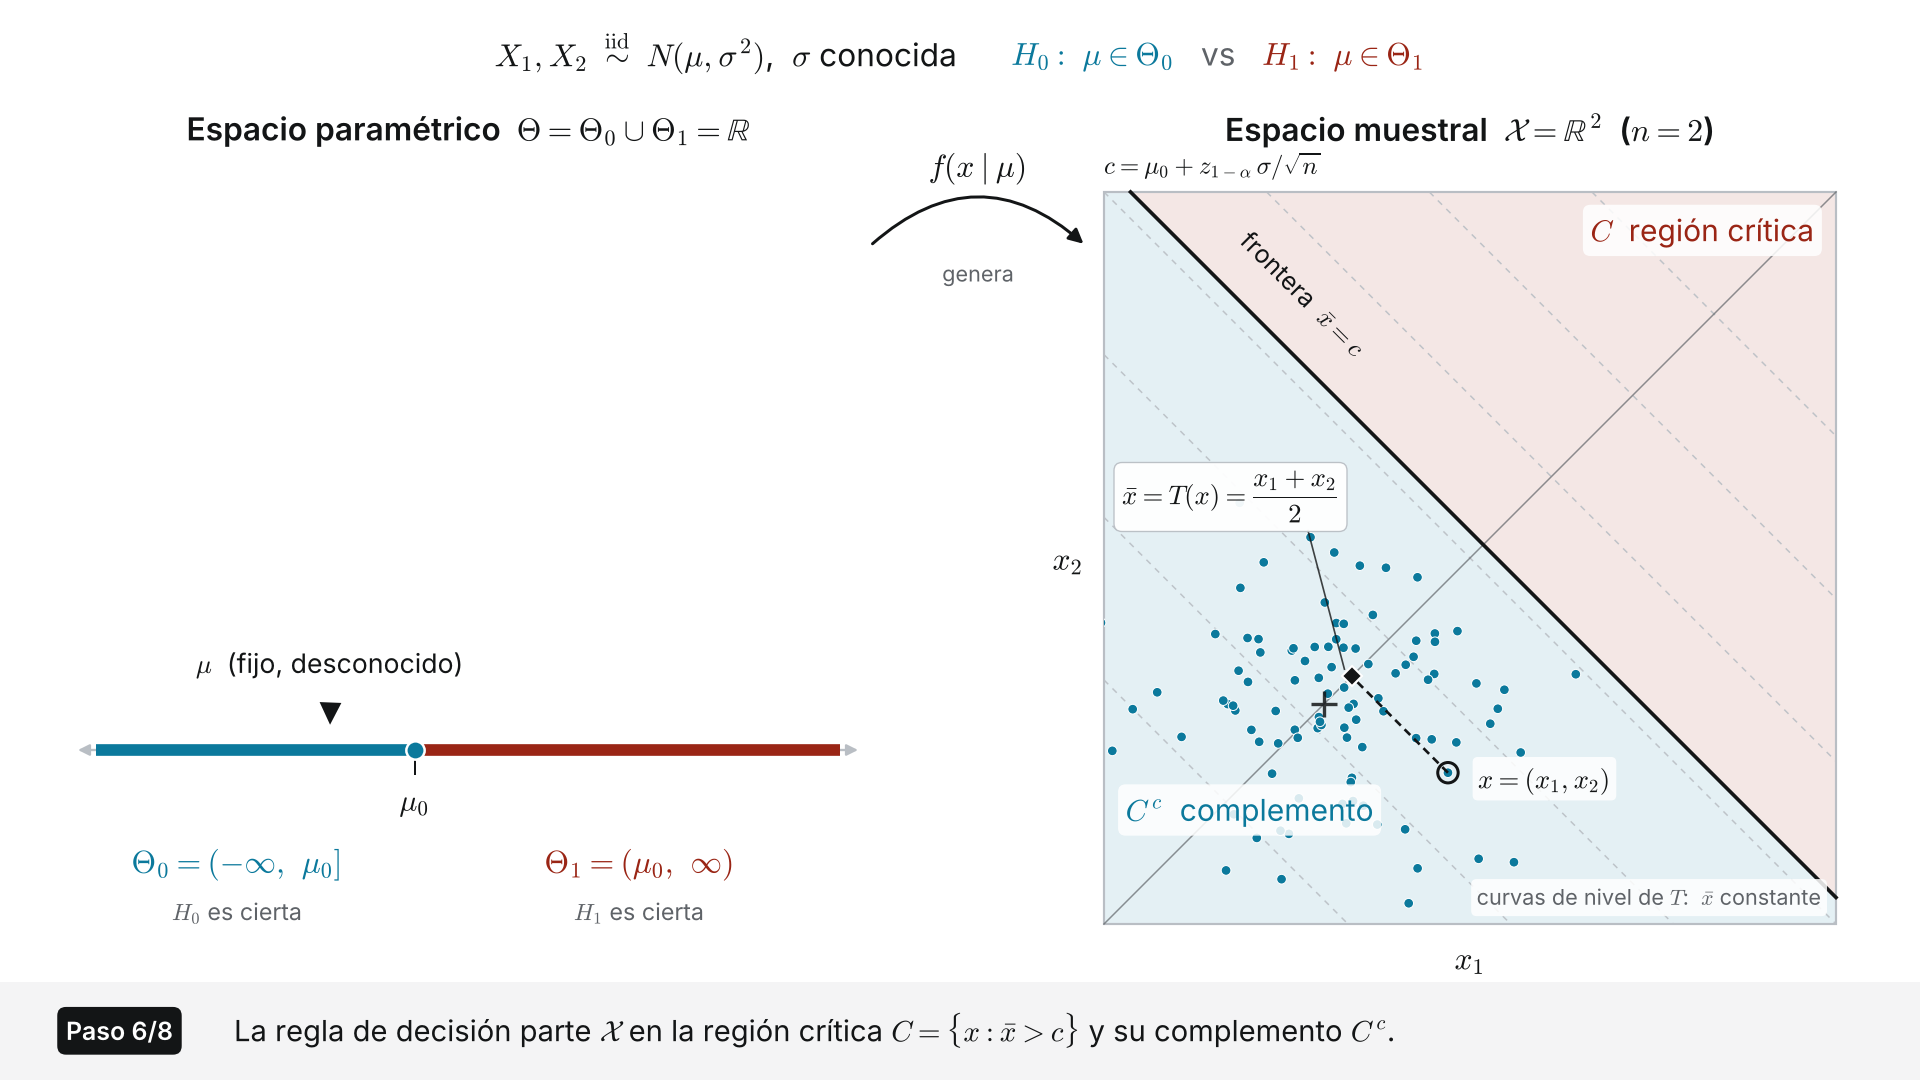
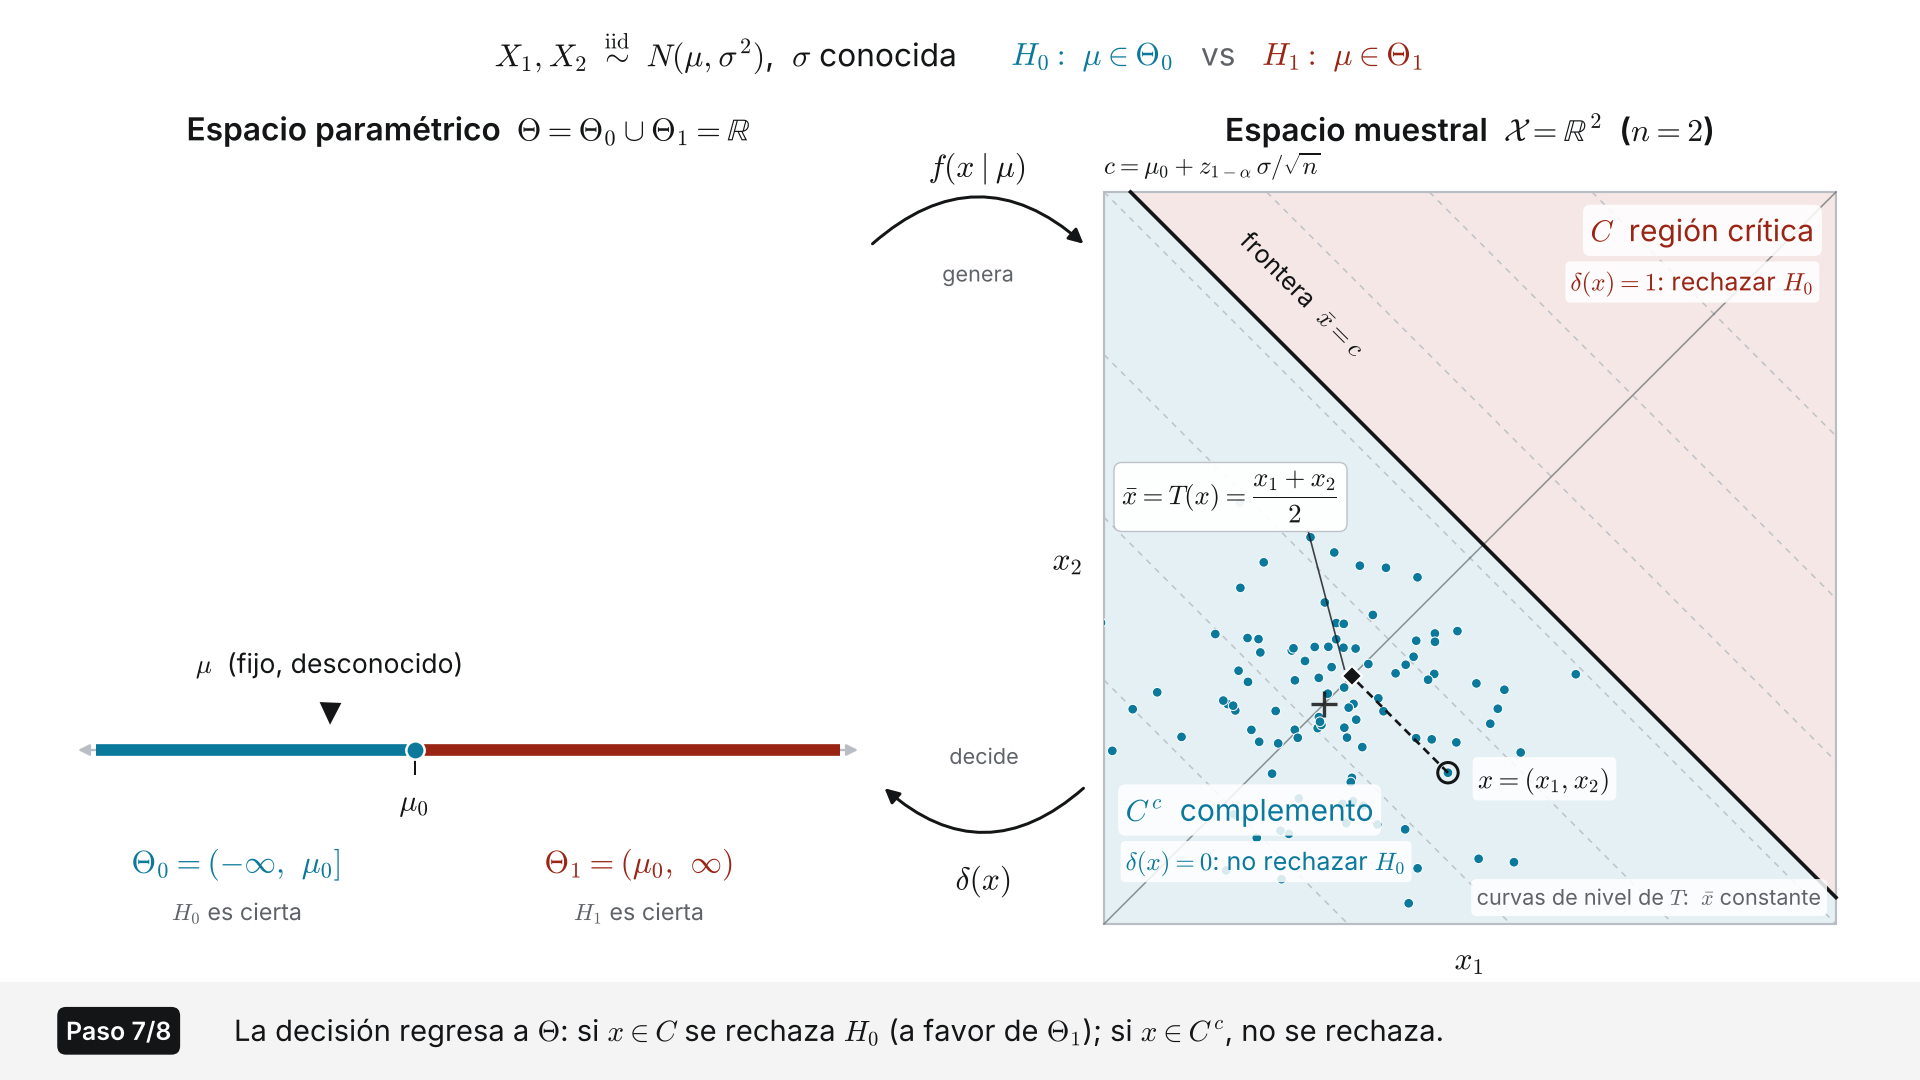
La forma de \(H_1\) determina dónde se ubica la región de rechazo.
Ejemplo:
Tres formas
| \(H_1\) | Nombre | Región de rechazo | Valor crítico |
|---|---|---|---|
| \(\mu < \mu_0\) | Unilateral izquierda | Una cola, la izquierda | \(-z_{1-\alpha}\) |
| \(\mu > \mu_0\) | Unilateral derecha | Una cola, la derecha | \(z_{1-\alpha}\) |
| \(\mu \neq \mu_0\) | Bilateral | Las dos colas, \(\alpha/2\) en cada una | \(\pm z_{1-\alpha/2}\) |
El área total de la región de rechazo siempre es \(\alpha\). En el caso bilateral esa área se reparte en partes iguales entre las dos colas, y por eso el valor crítico se busca con \(1-\alpha/2\).
Advertencia
El valor crítico depende de la distribución asociado al tipo de prueba (similar que los casos en el intervalo de confianza), a veces va a ser Normal, T-student, Chi-Cuadrado, etc.
Las tres regiones de rechazo
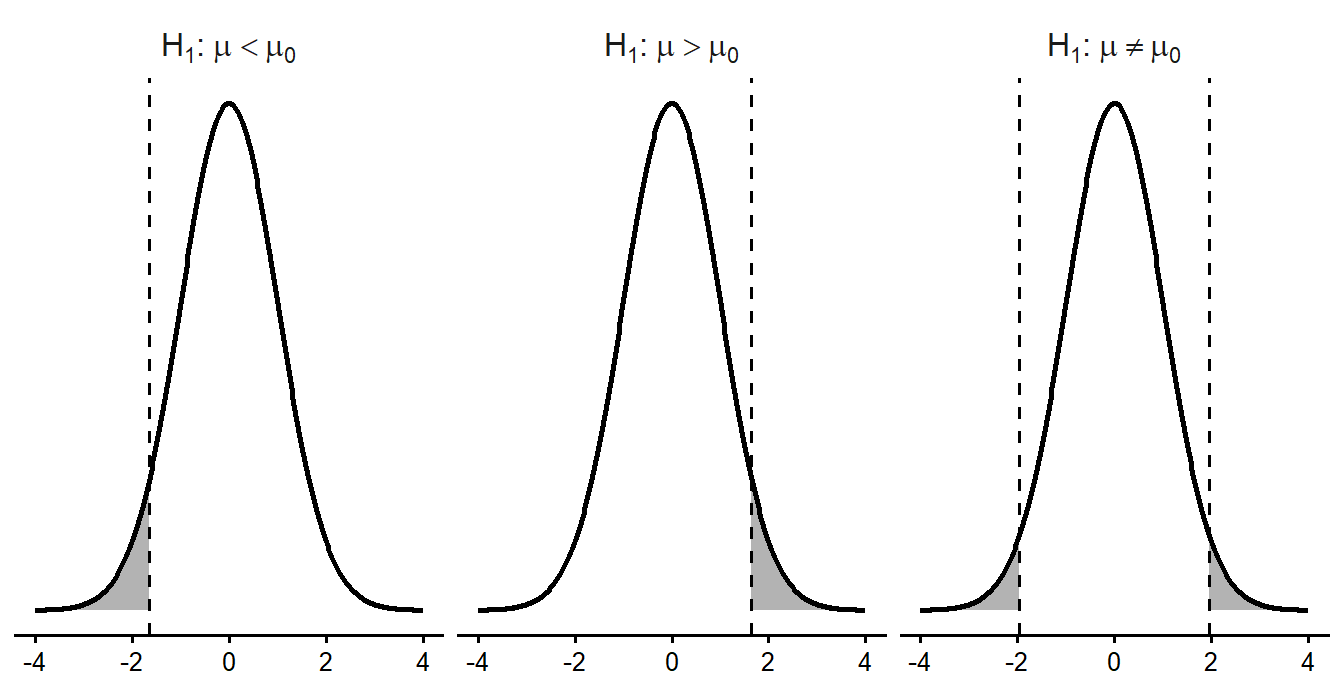
En los tres casos el área sombreada suma 0.05.
Ejercicio en clase 1
Para resolver ahora
Escriba la hipótesis nula y la alternativa, e indique si el contraste es bilateral o unilateral.
- Una municipalidad asegura que el tiempo promedio de respuesta a una denuncia es de 15 días. Los vecinos creen que tarda más.
- Un laboratorio sostiene que a lo sumo el 2% de sus pruebas da un falso positivo.
- Un supermercado cambió de proveedor y quiere verificar si el peso promedio de los paquetes sigue siendo el mismo.
- Se quiere saber si el sexo y la carrera elegida están relacionados.
- Un nutricionista afirma que la ingesta promedio de hierro de cierto grupo es de al menos 18 mg diarios.
- Para los casos a y b, indique cuál sería la región de rechazo al 5% y dibújela.
Errores tipo I y tipo II
Como la verdad es desconocida, toda decisión puede estar equivocada de dos maneras distintas.
Las cuatro situaciones posibles
| Decisión | \(H_0\) es verdadera | \(H_0\) es falsa |
|---|---|---|
| Rechazar \(H_0\) | Error tipo I (\(\alpha\)) | Decisión correcta (\(1-\beta\)) (Potencia) |
| No rechazar \(H_0\) | Decisión correcta (\(1-\alpha\)) | Error tipo II (\(\beta\)) |
\[\alpha = P(\text{rechazar } H_0 \mid H_0 \text{ verdadera}) \qquad \beta = P(\text{no rechazar } H_0 \mid H_0 \text{ falsa})\]
El error tipo I es el falso positivo: se declara un efecto que no existe.
El error tipo II es el falso negativo: existe un efecto y la prueba no lo detecta.
La relación entre los dos errores
Importante
Con el tamaño de muestra fijo, \(\alpha\) y \(\beta\) se mueven en direcciones opuestas.
La única forma de bajar los dos a la vez es aumentar \(n\): con más información las dos distribuciones se vuelven más concentradas y se traslapan menos.
En la práctica \(\alpha\) se fija de antemano y no se escoge después de ver los datos. Si se eligiera \(\alpha\) al ver el resultado, el procedimiento dejaría de controlar nada.
Ejemplo 2: ¿cuál error es más grave?
Tamizaje de una enfermedad
\(H_0\): la persona está sana, contra \(H_1\): la persona está enferma.
- Error tipo I: declarar enferma a una persona sana. Consecuencia: exámenes adicionales, angustia, quizá un tratamiento innecesario.
- Error tipo II: declarar sana a una persona enferma. Consecuencia: no recibe tratamiento a tiempo.
Aprobación de un medicamento
\(H_0\): el medicamento nuevo no es mejor que el actual, contra \(H_1\): sí lo es.
- Error tipo I: aprobar algo que no funciona y ponerlo en el mercado.
- Error tipo II: dejar de aprobar algo que sí funcionaba.
La gravedad relativa no es un asunto estadístico sino del contexto, y es lo que debería guiar la elección de \(\alpha\).
Nivel de significancia
Definición
El nivel de significancia \(\alpha\) es la probabilidad máxima que se está dispuesto a aceptar de cometer el error tipo I. Equivale al área de la región de rechazo.
Se fija antes de ver los datos. Los valores usuales son 0.10, 0.05 y 0.01, pero no tienen nada de sagrado: dependen del costo del falso positivo en el problema concreto.
Interpretación frecuentista: si \(H_0\) fuera verdadera y el estudio se repitiera muchas veces (mismo diseño y tamaño de muestra), la proporción de repeticiones en que la prueba rechazaría \(H_0\), cometiendo un error tipo I, se aproximaría a \(\alpha\).
Importante
\(\alpha\) no es la probabilidad de que \(H_0\) sea falsa. \(H_0\) es verdadera o falsa, no tiene una probabilidad asociada. \(\alpha\) es una propiedad del procedimiento, no de la hipótesis.
El estadístico de prueba
Definición
El estadístico de prueba mide a cuántos errores estándar se encuentra la estimación muestral del valor propuesto en \(H_0\).
\[\text{estadístico} = \frac{\text{estimador} - \text{valor propuesto}}{\text{error estándar del estimador}}\]
Bajo el supuesto de que \(H_0\) es verdadera, ese cociente sigue una distribución conocida: normal estándar, \(t\) de Student o ji-cuadrado, según el caso.
Toda la información de la muestra entra al procedimiento por este estadístico.
Nota
No siempre el estadístico de prueba tiene exactamente esa forma.
El valor p
Definición
El valor p es la probabilidad de obtener un estadístico de prueba al menos tan extremo como el observado, suponiendo que \(H_0\) es verdadera.
\[\text{Unilateral derecha: } p = P(Z \ge z_c) \qquad \text{Unilateral izquierda: } p = P(Z \le z_c)\]
\[\text{Bilateral: } p = 2\,P(Z \ge |z_c|)\]
Un valor p pequeño significa que, si \(H_0\) fuera cierta, una muestra como la observada sería rara. Eso es evidencia contra \(H_0\).
Importante
No siempre es una \(Z\) (Normal Estándar), depende de los casos. A veces usaremos t-student, Chi, F de Fisher, etc.
Regla de decisión y conclusión
Hay tres criterios equivalentes. Siempre conducen a la misma decisión.
Criterio 1: valor crítico
Se rechaza \(H_0\) si el estadístico calculado cae en la región de rechazo, es decir si supera al valor crítico en la dirección de \(H_1\).
Criterio 2: valor p
Se rechaza \(H_0\) si \(p < \alpha\). No se rechaza si \(p \ge \alpha\).
Criterio 3: intervalo de confianza
En un contraste bilateral, se rechaza \(H_0: \theta = \theta_0\) al nivel \(\alpha\) si el intervalo de confianza del \(100(1-\alpha)\%\) no contiene a \(\theta_0\).
Cómo se escribe la conclusión
Una conclusión completa tiene cuatro piezas:
- El nivel de significancia usado.
- Si hay o no evidencia estadística suficiente.
- La hipótesis sobre la que se decide.
- Qué significa eso en el problema, en las unidades del problema.
Dos plantillas
Si se rechaza: con un nivel de significancia del 5% hay suficiente evidencia estadística para rechazar la hipótesis nula de que el contenido promedio es de 600 mg; se concluye que el contenido promedio es mayor.
Si no se rechaza: con un nivel de significancia del 5% no hay suficiente evidencia estadística para rechazar la hipótesis nula de que el contenido promedio es de 600 mg.
Nunca se escribe se acepta \(H_0\), ni se concluye que \(H_0\) es verdadera.
Significancia estadística e importancia práctica
Importante
Significativo en estadística quiere decir difícil de explicar por azar muestral. No quiere decir grande, ni relevante, ni importante.
En la práctica puede ser que una diferencia de 1 cm sea estadísticamente significativa, pero a nivel práctico 1 cm en la altura de un árbol no sea relevante para el experto.
La significancia estadística tiene que ver con los datos y la prueba de hipótesis propiamente.
La significancia relevante se asocia con la diferencia mínima que termina siendo práctica para el contexto del experto.
Ejemplo 3: significativo pero irrelevante
Una envasadora declara 500 g por paquete. Con \(\sigma = 20\) g conocida se toma una muestra de 10 000 paquetes y se obtiene \(\bar x = 500.6\) g. Contraste al 5% si el contenido promedio difiere de 500 g.
Idea:
Hipótesis: \(H_0: \mu = 500\) contra \(H_1: \mu \neq 500\)
Suponga que se rechaza \(H_0\)
Como se rechaza hay suficiente evidencia estadística para rechazar \(H_0\) (Hay diferencia significativa).
Pero \(500.6-500=0.06\) g. puede que no represente una diferencia relevante para la envasadora.
Potencia de la prueba
Definición
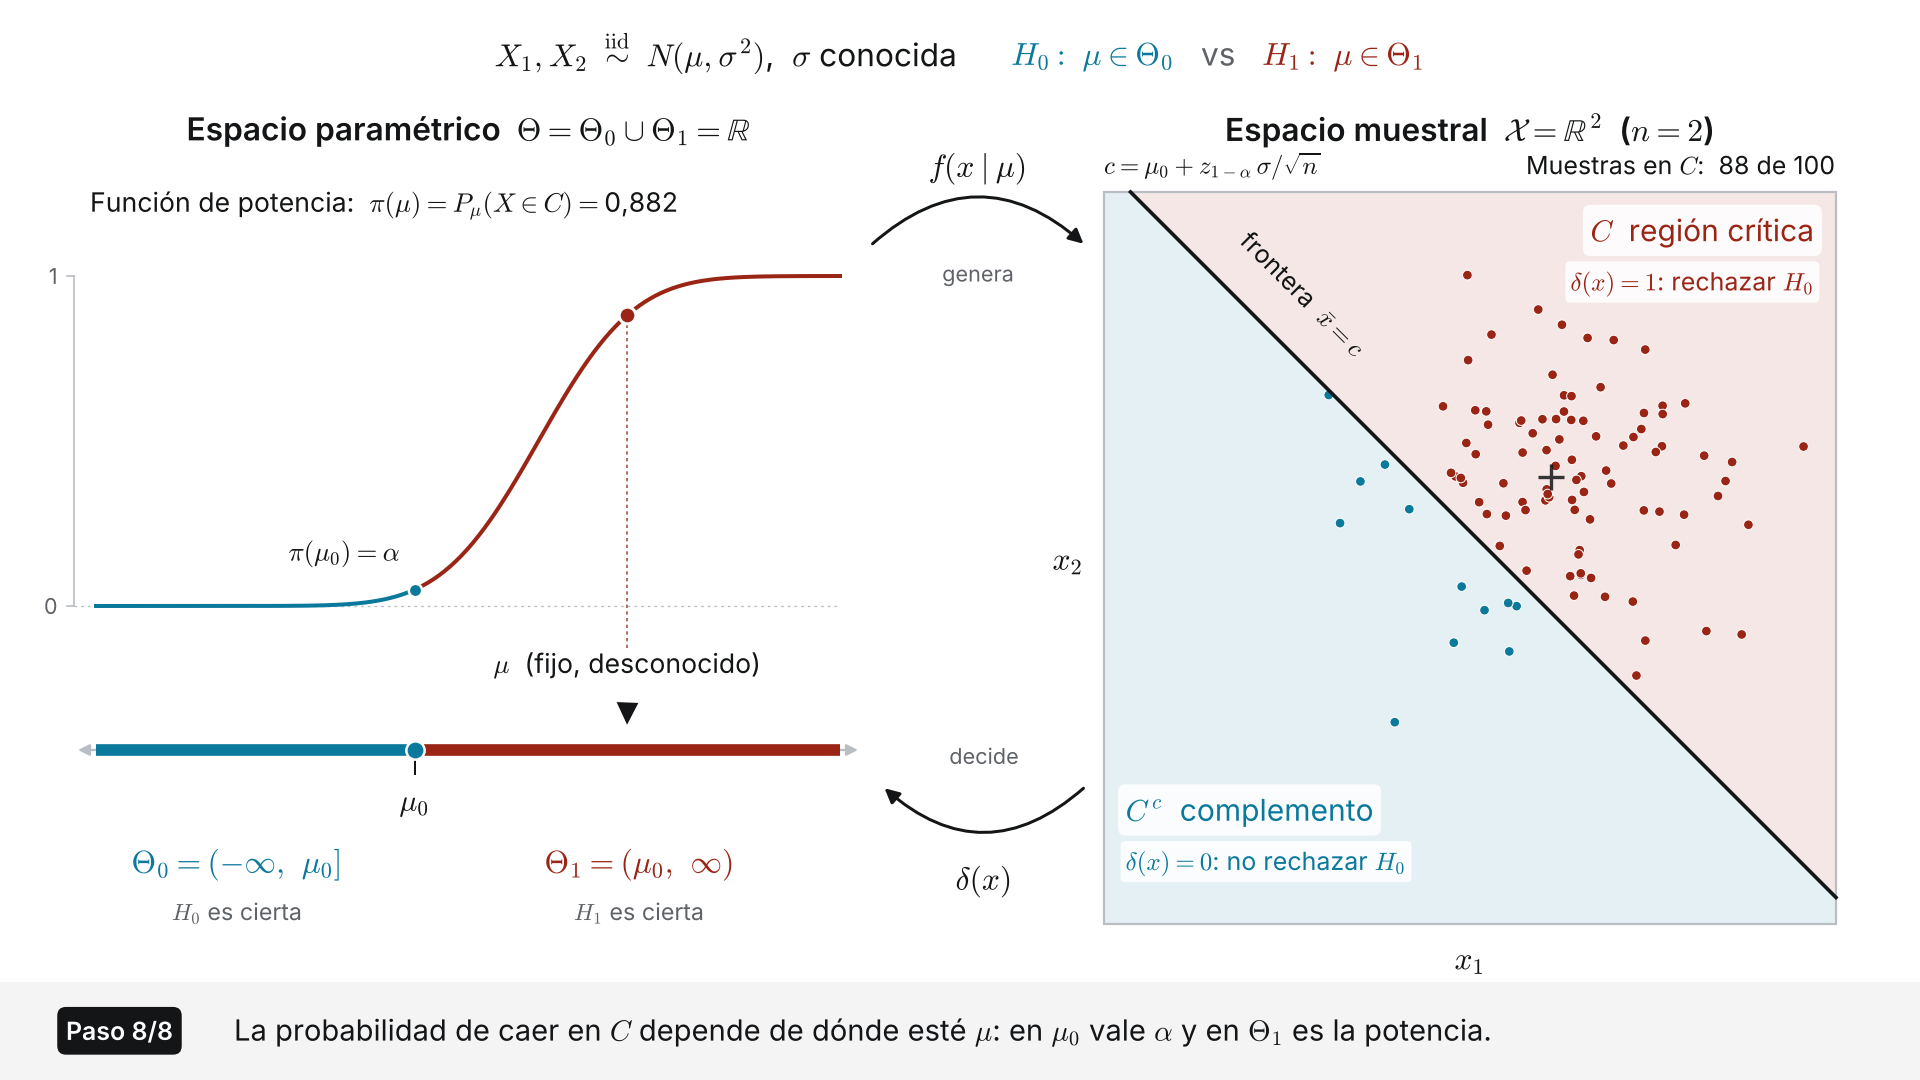
La potencia es la probabilidad de rechazar \(H_0\) cuando \(H_0\) es efectivamente falsa.
\[\text{Potencia} = 1 - \beta = P(\text{rechazar } H_0 \mid H_0 \text{ falsa})\]
Es la capacidad de la prueba para detectar un efecto que sí existe. Una prueba con potencia baja no sirve de mucho: si no rechaza, no se sabe si es porque no hay efecto o porque la prueba no podía verlo.
De qué depende la potencia
La potencia aumenta cuando:
- Aumenta el tamaño de muestra \(n\), porque el error estándar baja.
- Aumenta la distancia entre el valor real y el valor propuesto en \(H_0\).
- Disminuye la variabilidad \(\sigma\) de la población.
- Aumenta \(\alpha\), porque la región de rechazo se agranda. Pero esto se paga con más falsos positivos (mayor error tipo I).
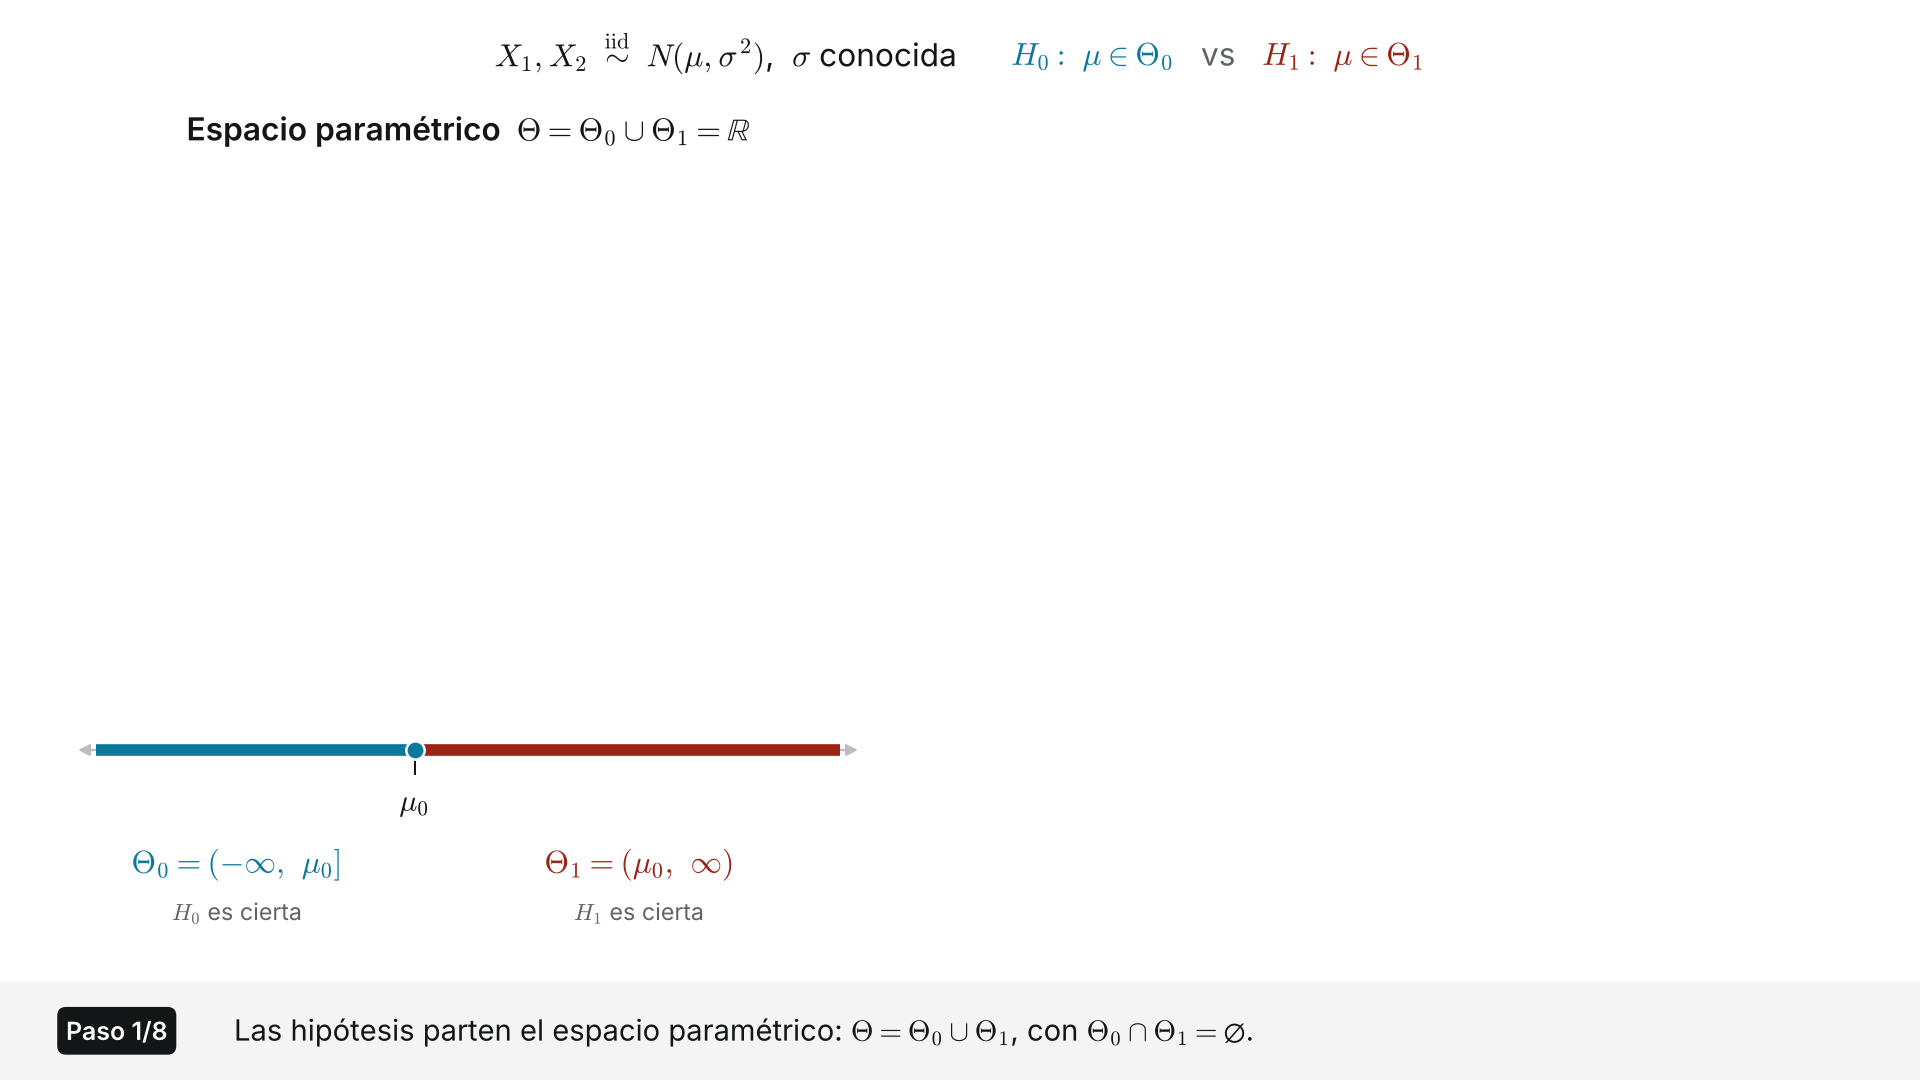
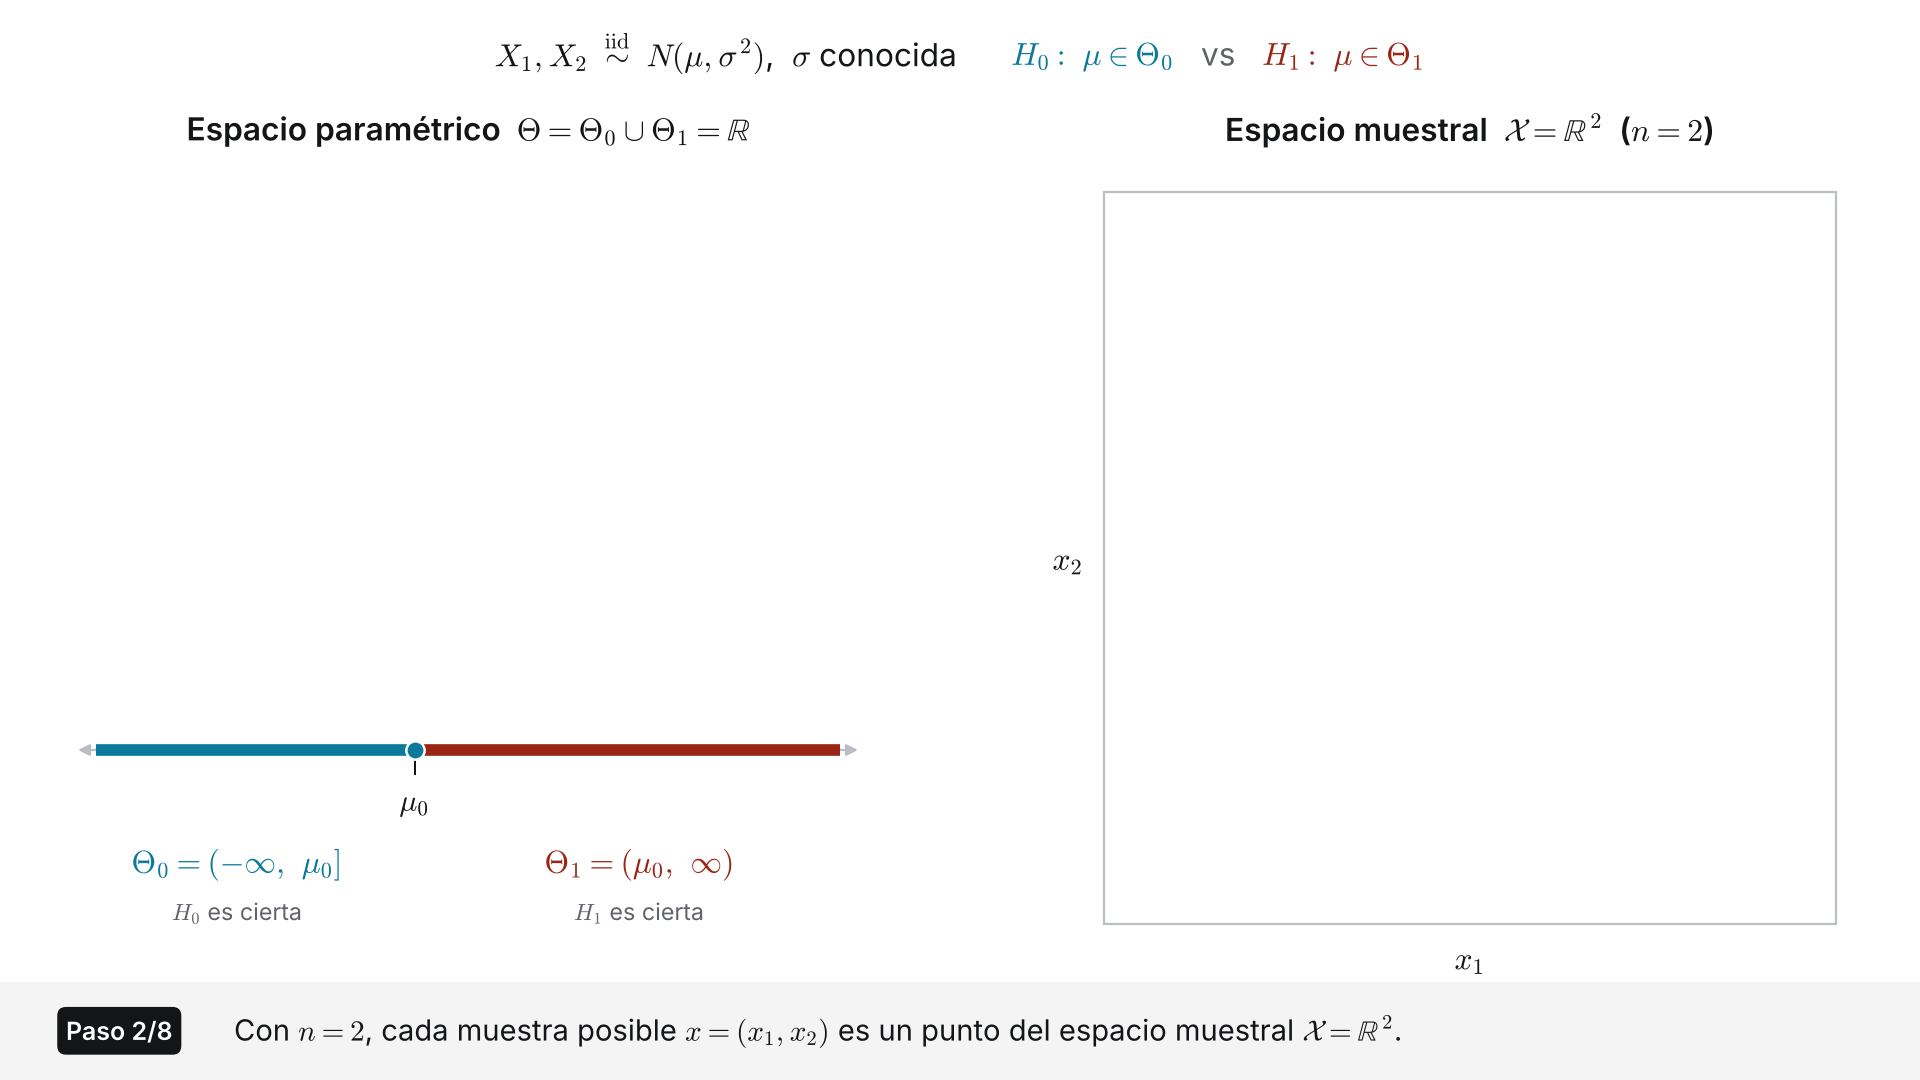
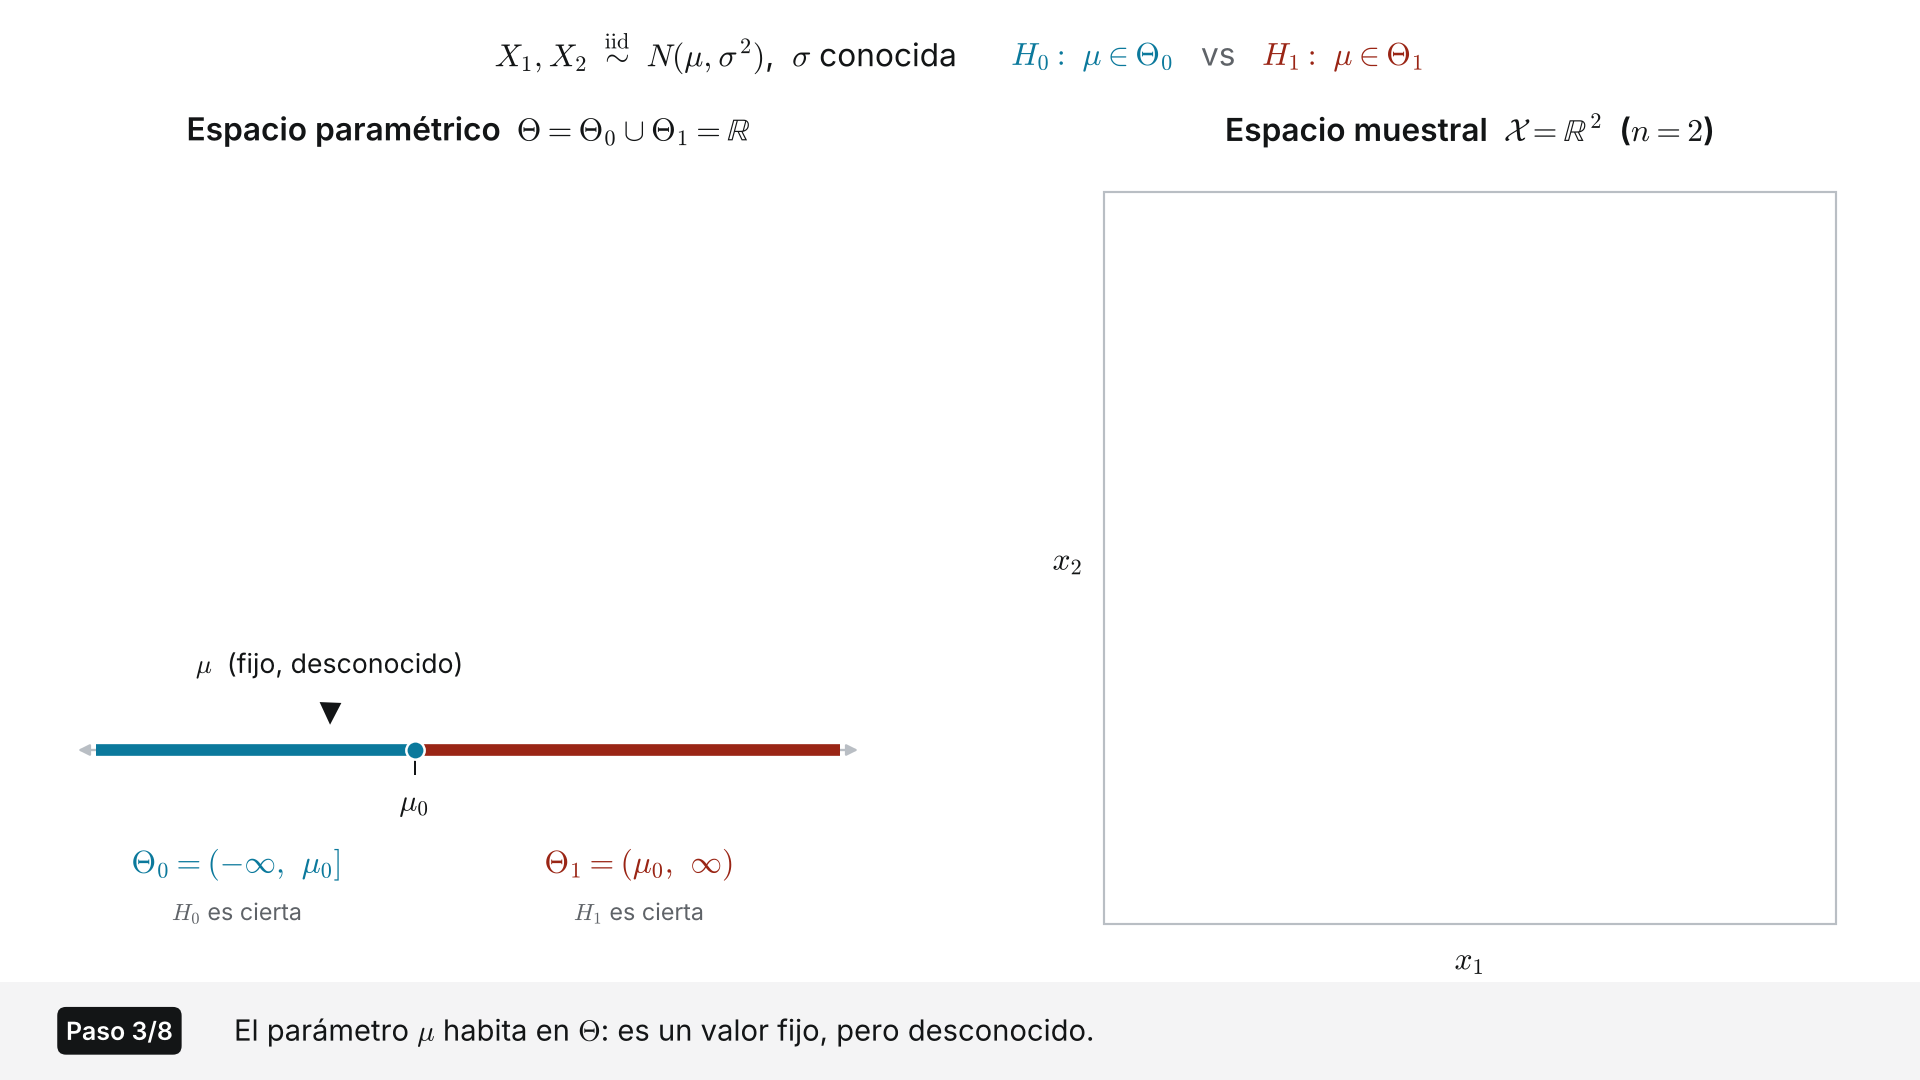
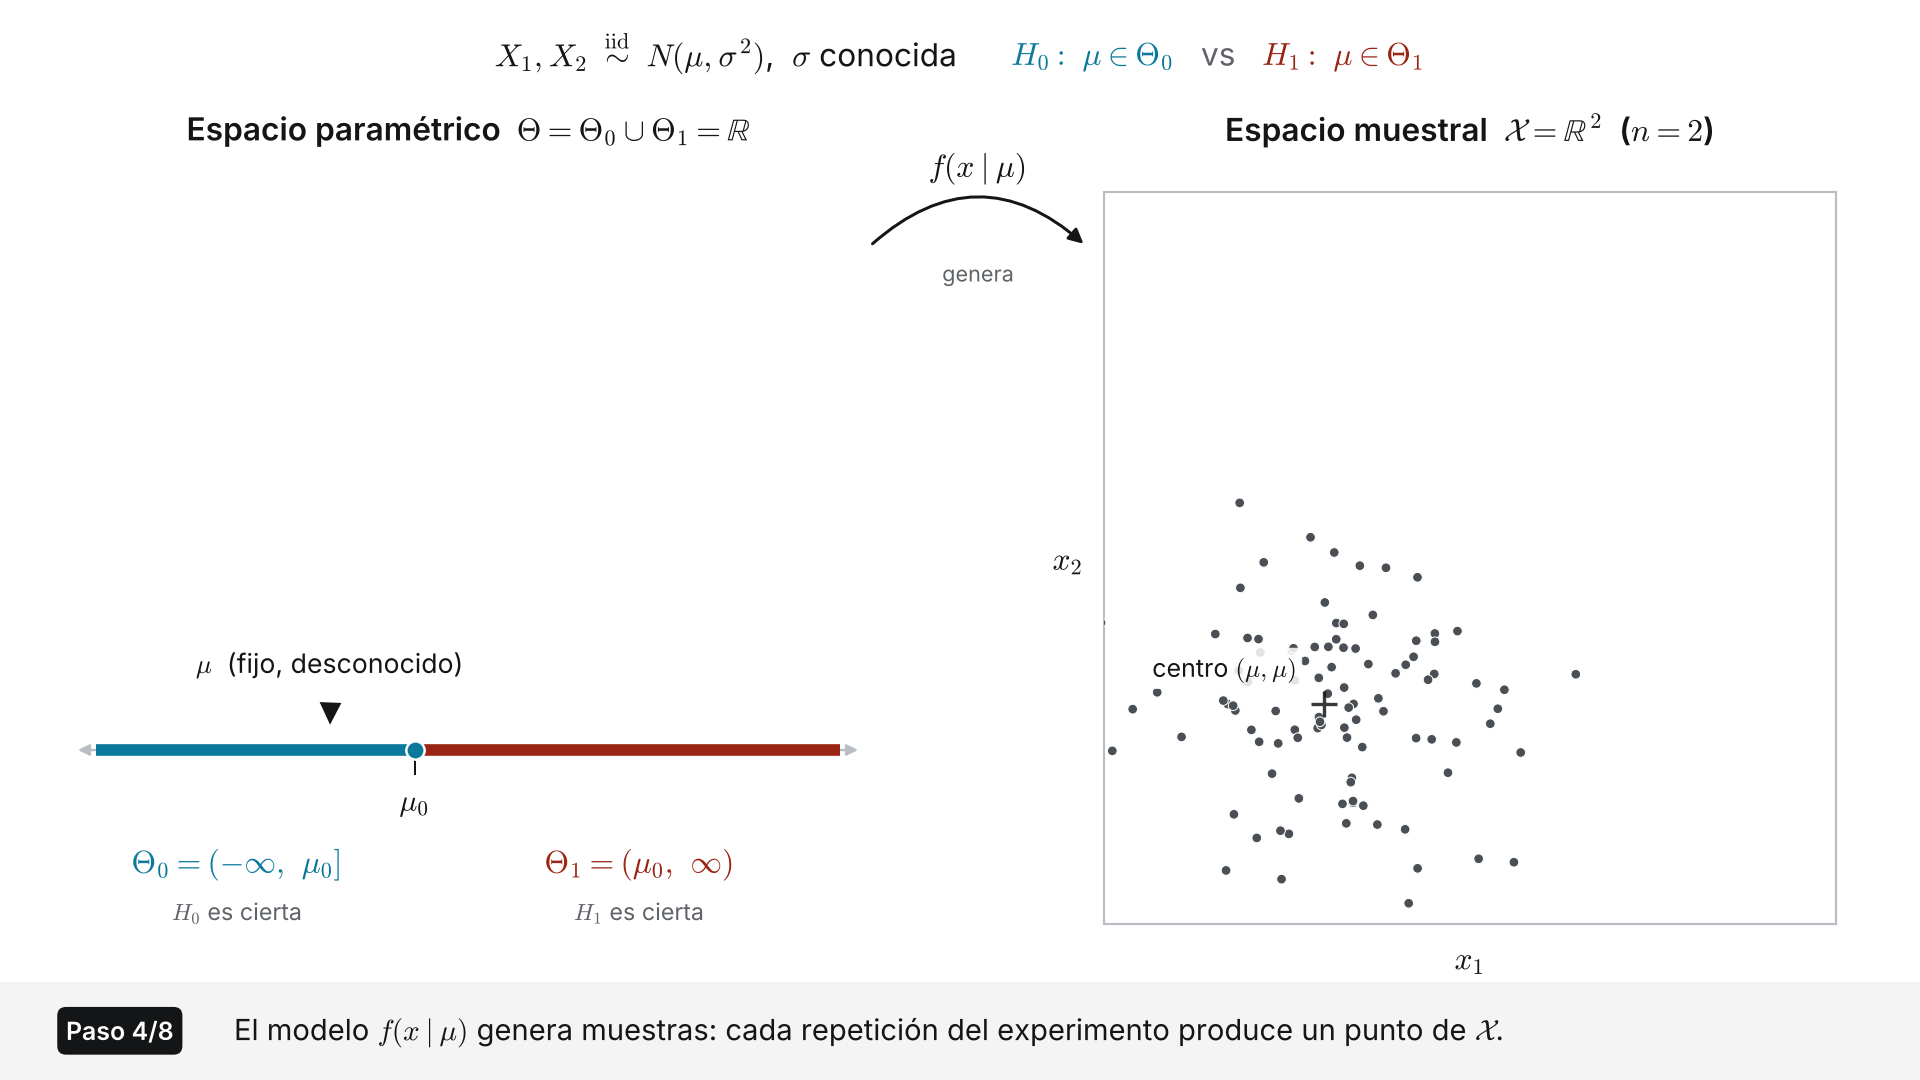
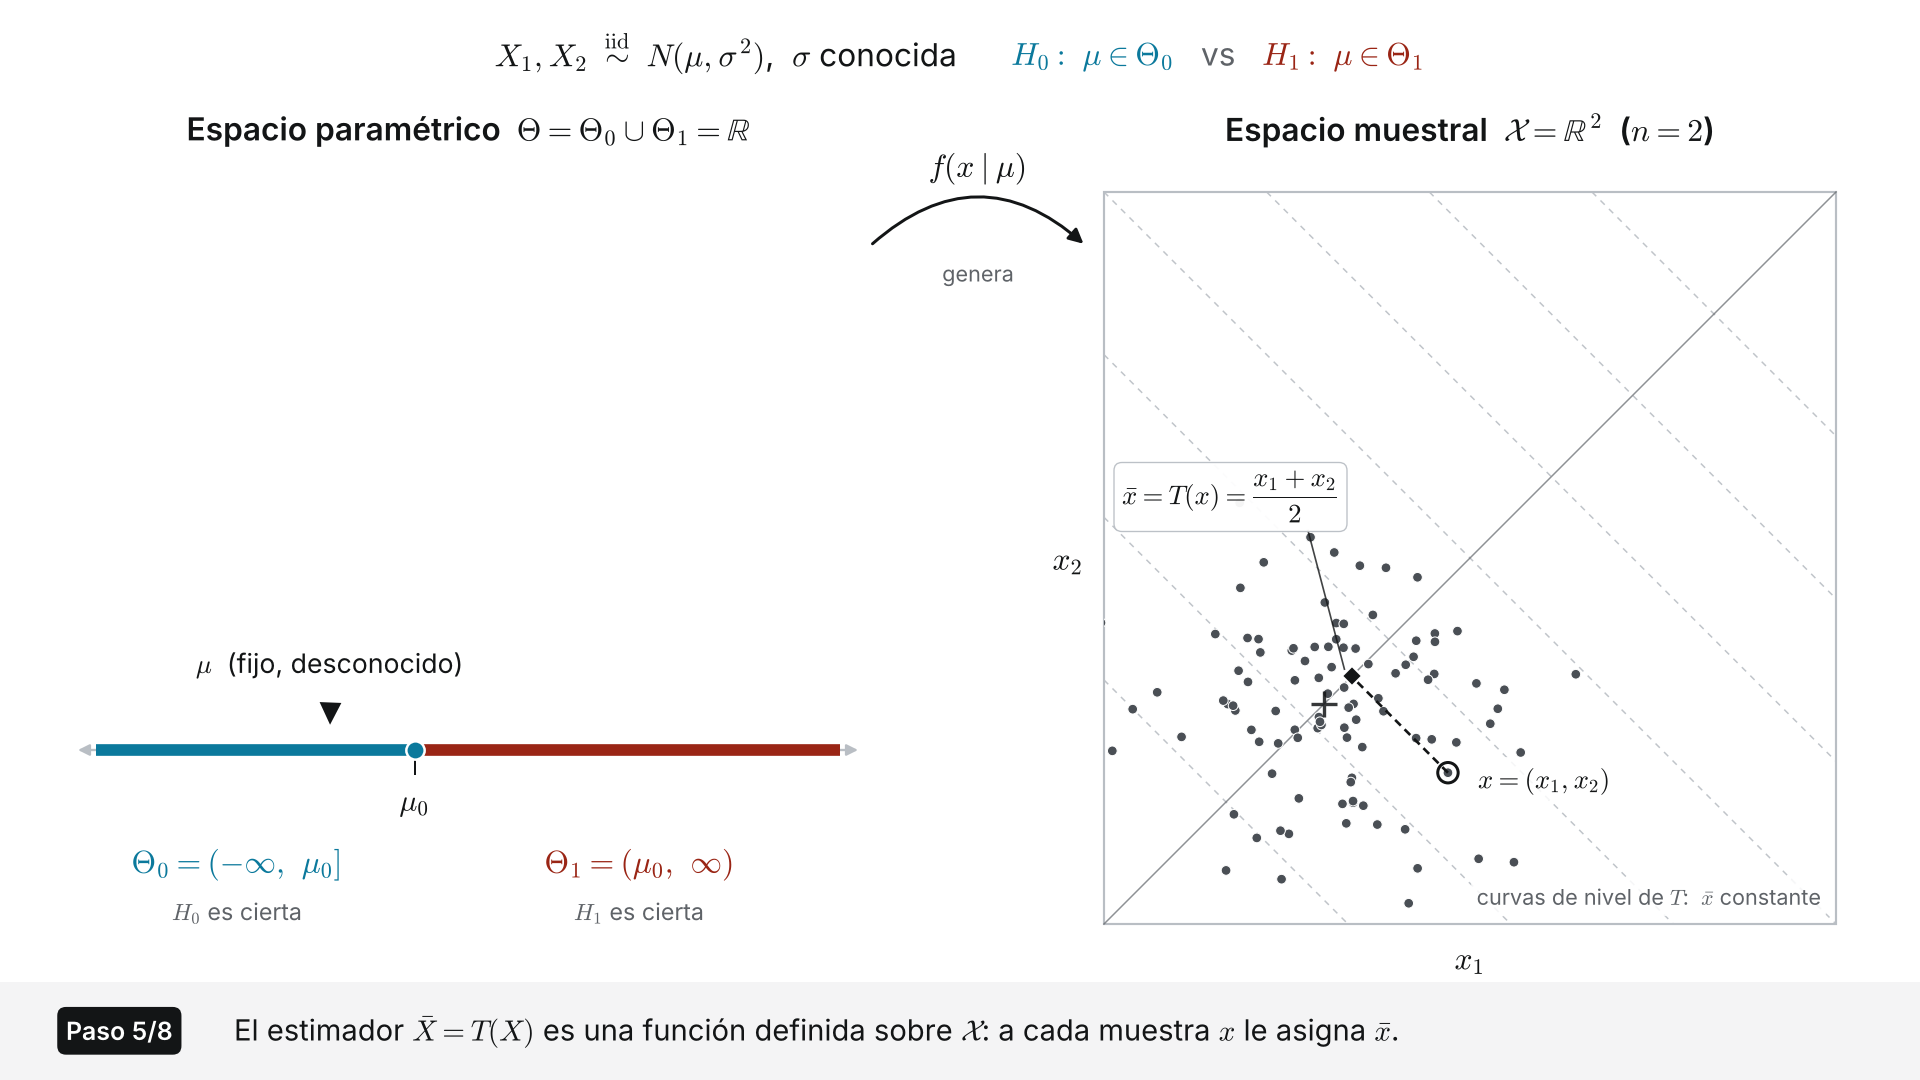
⚠ Una comprensión más profunda
Ejercicios 1 a 3
Para cada enunciado escriba la hipótesis nula y la alternativa, indique cuál es el parámetro de interés y diga si el contraste es unilateral izquierdo, unilateral derecho o bilateral.
- Una panadería afirma que sus bolsas de pan contienen en promedio 450 gramos. Un inspector sospecha que contienen menos.
- Un banco sostiene que el tiempo promedio de espera en sus cajas no supera los 7 minutos.
- Una campaña de vacunación se propuso alcanzar una cobertura del 85% de la población meta. Al cierre se quiere saber si la cobertura real difiere de esa meta.
- Un ingeniero cambió la fórmula de un concreto y quiere saber si la resistencia promedio se modificó.
- Un sociólogo quiere demostrar que más de la mitad de los hogares de un cantón tiene acceso a internet.
- Una universidad quiere saber si la carrera elegida y la provincia de procedencia están relacionadas.
- Un laboratorio garantiza que al menos el 99% de sus reactivos pasa el control de calidad.
- Un investigador escribió \(H_0: \mu = 73.4\), donde 73.4 es el promedio que obtuvo en su muestra. Explique por qué ese planteamiento invalida el procedimiento.
En cada caso indique en cuál cola o colas queda la región de rechazo, cuánta área le corresponde a cada una y cuál es el valor crítico, suponiendo que el estadístico se distribuye normal estándar. Puede apoyarse en qnorm.
- \(H_1: \mu > \mu_0\) con \(\alpha = 0.05\)
- \(H_1: \mu < \mu_0\) con \(\alpha = 0.01\)
- \(H_1: \mu \neq \mu_0\) con \(\alpha = 0.05\)
- \(H_1: \mu \neq \mu_0\) con \(\alpha = 0.02\)
- \(H_1: P > P_0\) con \(\alpha = 0.10\)
- Dibuje a mano las curvas de los incisos a, c y e, sombree la región de rechazo y ubique el valor crítico.
- Compare los valores críticos de los incisos c y d. ¿Por qué el del inciso d está más alejado del cero?
- Un compañero afirma que, como en el inciso c la región de rechazo se parte en dos, cada mitad debe tener un área de 0.05. Corrija la afirmación.
Para cada situación, describa en términos del problema qué significa cometer el error tipo I y qué significa cometer el error tipo II, indique la consecuencia de cada uno, diga cuál le parece más grave y qué nivel de significancia escogería, justificando.
- Control de calidad. \(H_0\): el lote cumple la norma sanitaria, contra \(H_1\): no la cumple.
- Un detector de humo. \(H_0\): no hay fuego, contra \(H_1\): hay fuego.
- Un filtro de correo. \(H_0\): el correo es legítimo, contra \(H_1\): el correo es basura.
- Revisión estructural de un puente. \(H_0\): la estructura es segura, contra \(H_1\): no lo es.
- Selección de personal mediante una prueba de admisión. \(H_0\): la persona no cumple el perfil, contra \(H_1\): sí lo cumple.
- Un ensayo clínico de un medicamento con efectos secundarios conocidos. \(H_0\): el medicamento no es mejor que el actual, contra \(H_1\): sí lo es.
- Escoja dos de los casos anteriores en los que su respuesta sobre cuál error es más grave fue distinta, y explique qué cambió en el contexto para que cambiara la respuesta.
Ejercicios 4 a 6
En cada situación se describe lo que ocurrió. Indique si se cometió un error tipo I, un error tipo II, o si la decisión fue correcta. Justifique en una línea identificando primero cuál era \(H_0\).
- Se concluyó que un fertilizante aumentaba el rendimiento. Tres años después, estudios más amplios mostraron que no tenía ningún efecto.
- Una prueba de tamizaje reportó que una persona estaba sana cuando en realidad tenía la enfermedad.
- Un filtro de correo envió a la carpeta de basura un mensaje legítimo del jefe.
- Un filtro de correo dejó pasar a la bandeja de entrada un mensaje de publicidad no deseada.
- Se rechazó la hipótesis nula de que una máquina estaba calibrada, y efectivamente estaba descalibrada.
- No se rechazó la hipótesis nula de que dos variables son independientes, y en la población realmente lo son.
- Un jurado declaró no culpable a una persona que había cometido el delito.
- Una auditoría no detectó un faltante que sí existía en el inventario.
- De los ocho casos anteriores, ¿en cuáles se puede saber con certeza que hubo error y en cuáles habría sido imposible saberlo en el momento de tomar la decisión? Comente qué implica eso para la práctica.
Complete el cuadro indicando si cada cantidad aumenta, disminuye o no cambia. Justifique cada fila en una línea.
| Cambio | \(\alpha\) | \(\beta\) | Potencia |
|---|---|---|---|
| Aumenta \(n\), todo lo demás fijo | |||
| Se baja \(\alpha\) de 0.05 a 0.01, con \(n\) fijo | |||
| El verdadero valor del parámetro se aleja más de \(H_0\) | |||
| La población es más variable, es decir \(\sigma\) mayor |
- Complete las doce casillas.
- ¿Cuál de las cuatro filas es la única que mejora las dos cosas a la vez? Explique por qué.
- Un investigador quiere bajar \(\alpha\) a 0.001 porque dice que así su estudio será más riguroso, y mantiene el mismo tamaño de muestra. ¿Qué le respondería?
- Un estudio con potencia estimada de 0.25 no rechazó \(H_0\). ¿Qué se puede concluir del parámetro? Justifique.
- Explique por qué la potencia no es un único número sino que depende del verdadero valor del parámetro.
Un ministerio evaluó una reforma educativa comparando el puntaje promedio de una prueba nacional antes y después. Con 50 000 estudiantes evaluados, el promedio pasó de 70.0 a 70.4 puntos en una escala de 0 a 100, y el informe reporta un valor p menor a 0.001. El titular del comunicado de prensa dice: la reforma mejoró significativamente el rendimiento de los estudiantes.
- ¿Es correcto, desde el punto de vista estadístico, decir que el resultado es significativo? Justifique.
- ¿Es correcto el titular tal como está redactado? Señale exactamente dónde está el problema.
- ¿Qué información adicional le pediría al ministerio antes de aceptar la conclusión?
- Suponga que el mismo estudio se hubiera hecho con 200 estudiantes y hubiera dado la misma diferencia de 0.4 puntos. ¿Esperaría un valor p mayor o menor? Justifique sin calcular.
- Reescriba el titular de forma que sea defendible.
- Explique por qué, con un tamaño de muestra suficientemente grande, casi cualquier diferencia termina siendo estadísticamente significativa.
Ejercicios 7 y 8
Cada una de las siguientes frases apareció en un informe. Todas tienen al menos un error. Identifique el error y reescriba la frase de forma correcta.
- Con un nivel de significancia del 5% se acepta la hipótesis nula de que el contenido promedio es de 600 mg.
- El valor p resultó 0.02, de modo que hay un 2% de probabilidad de que la hipótesis nula sea cierta.
- Como el valor p dio 0.07, trabajaremos con un nivel de significancia del 10% para poder rechazar.
- Se rechazó la hipótesis nula, por lo tanto queda demostrado que el promedio poblacional es 612 mg.
- No se rechazó la hipótesis nula, así que las dos variables son independientes.
- El resultado fue altamente significativo, por lo tanto el efecto encontrado es muy importante en la práctica.
- Se planteó \(H_0: \mu = 218.5\), que es el promedio obtenido en la muestra.
- Con un 95% de confianza se rechaza la hipótesis nula.
- El nivel de significancia del 5% indica que la prueba se equivoca en el 5% de las conclusiones que emite.
- Como el estadístico calculado dio negativo, se rechaza la hipótesis nula.
Marque con equis la única opción correcta en cada caso.
- Una hipótesis estadística es una afirmación sobre:
- La hipótesis nula:
- El valor de referencia que aparece en \(H_0\) proviene de:
- Un investigador quiere demostrar que una proporción poblacional supera 0.25. La alternativa correcta es:
- En un contraste bilateral con \(\alpha = 0.04\), el área de cada cola de la región de rechazo es:
- El error tipo I consiste en:
- Con el tamaño de muestra fijo, si se disminuye \(\alpha\):
- La potencia de una prueba se calcula como:
- Se obtuvo un valor p de 0.12 habiendo fijado \(\alpha = 0.05\). La decisión es:
- El valor p es:
- Que un resultado sea estadísticamente significativo quiere decir que:
- Si se aumenta el tamaño de muestra y todo lo demás se mantiene igual:
Ejercicios 9 y 10
Indique si cada afirmación es falsa o verdadera y justifique su respuesta en una línea.
- Una hipótesis estadística se refiere siempre a la población y no a la muestra.
- El valor de referencia de la hipótesis nula se obtiene de los datos recolectados.
- No rechazar \(H_0\) equivale a demostrar que \(H_0\) es verdadera.
- La hipótesis alternativa nunca lleva el signo de igualdad.
- En un contraste bilateral al 5%, cada cola de la región de rechazo tiene un área de 0.05.
- El nivel de significancia se escoge después de calcular el valor p, para poder tomar la mejor decisión.
- \(\alpha\) es la probabilidad de que la hipótesis nula sea verdadera.
- El error tipo II se comete al no rechazar una hipótesis nula falsa.
- Con el tamaño de muestra fijo, \(\alpha\) y \(\beta\) se mueven en la misma dirección.
- Aumentar el tamaño de muestra permite reducir \(\alpha\) y \(\beta\) a la vez.
- La potencia de una prueba depende de cuál sea el verdadero valor del parámetro.
- Un valor p muy pequeño indica que el efecto encontrado es grande.
- Una diferencia estadísticamente significativa siempre es relevante en la práctica.
- Si el intervalo de confianza del 95% no contiene al valor propuesto, el contraste bilateral al 5% rechaza \(H_0\).
- El valor crítico siempre se busca en la distribución normal estándar.
- La decisión de un contraste de hipótesis puede enunciarse como aceptar \(H_0\).
- Dos investigadores que analizan los mismos datos con distinto \(\alpha\) pueden llegar a decisiones distintas sin que ninguno se haya equivocado en los cálculos.
Primera parte. Complete cada enunciado con el concepto que corresponde.
- Una hipótesis estadística es una afirmación sobre un _____ de la población o sobre la _____ que esta sigue, y nunca sobre la _____.
- La hipótesis _____ siempre lleva el signo de igualdad, porque es la que permite calcular la _____ del estadístico de prueba.
- Rechazar \(H_0\) cuando es verdadera es el error tipo _____, llamado falso _____, y su probabilidad se denota _____.
- No rechazar \(H_0\) cuando es falsa es el error tipo _____, llamado falso _____, y su probabilidad se denota _____.
- La _____ de una prueba es la probabilidad de rechazar \(H_0\) cuando es _____, y se calcula como \(1 -\) _____.
- El conjunto de valores del estadístico que llevan a rechazar \(H_0\) se llama _____, y su área total vale _____.
- En un contraste bilateral esa área se reparte en _____ partes iguales, y por eso el valor crítico se busca con _____.
- El _____ es la probabilidad de obtener un resultado al menos tan extremo como el observado suponiendo que _____ es verdadera, y se rechaza \(H_0\) cuando resulta _____ que \(\alpha\).
- La única forma de reducir \(\alpha\) y \(\beta\) al mismo tiempo es aumentar el _____.
- Significativo en estadística quiere decir difícil de explicar por _____, y no quiere decir _____.
Segunda parte. Responda de forma breve.
- Explique por qué \(H_0\) siempre lleva el signo de igualdad y qué pasaría con el procedimiento si no lo llevara.
- Explique por qué se dice no se rechaza y no se acepta.
- ¿Por qué \(\alpha\) se fija antes de ver los datos?
- Explique la diferencia entre el nivel de confianza y el nivel de significancia, y la relación que hay entre los dos.
- Un investigador escoge \(\alpha = 0.01\) en lugar de 0.05. ¿Qué gana y qué pierde?
- ¿Por qué el valor de referencia de \(H_0\) no puede salir de la muestra?
- Explique en qué se parecen y en qué se diferencian la estimación por intervalo y el contraste de hipótesis.
- Dé un ejemplo propio, de su área de interés y distinto de los vistos en clase, en el que el error tipo II sea más grave que el error tipo
- Investigue qué se entiende por tamaño del efecto y por qué se recomienda reportarlo junto al valor p.